Deset dílů, tři stroje, stovky měření. Co na lokální AI server skutečně nasadit
Začali jsme čipem, do kterého je model vypálený natvrdo. Skončili jsme u agenta, kterého přemluvil jeden řádek v patičce e-mailu. Mezi tím jsme změřili rychlost, kód, češtinu, agenty, velké modely i evropskou serverovnu. Tady je všechno v jedné tabulce — co nasadit, na jakou úlohu a co k tomu musí být v kódu.
Na čem stojí závěry
Série běžela na třech strojích a je potřeba je držet odděleně:
- Ryzen 9 se 128 GB (díly 2–3) — hypotetická sestava, spočítaná, nekoupená,
- VPS s 32 GB a 16 vlákny (srpen) — první měření kódu a nástrojů,
- server s 62 GB a 24 virtuálními jádry (září, díly 4–8) — čtrnáct modelů, čtyři testovací sady, všechno skriptované.
Tabulky v tomhle dílu jsou ze zářijového serveru, pokud není uvedeno jinak. Grafická karta nebyla nikde.
Co na takový stroj nasadit
| Úloha | Model | Proč |
|---|---|---|
| agent řídící proces — e-maily, rezervace | gemma4:26b-a4b | 7/8, s kalkulačkou 8/8; jediný bez halucinované akce; prefill 77 t/s |
| kód — webové aplikace | qwen3.6:35b-a3b-coding | hra 13/16 napoprvé, mini-úlohy nakonec 8/8 |
| kód — krátká logika, rychle | Laguna XS 2.1 | mini-úlohy 8/8 za 3,7 min, IČO 11/11 za 21 s, 15,7 t/s |
| kód — druhý názor | north-mini-code-1.0 | hra 15/16 po jedné iteraci |
| algoritmy napoprvé | qwen3-next:80b-a3b | mini-úlohy 7/8 napoprvé, přitom 8 t/s |
| nástroje + čtení obrázků | muse-glimmer:30b-dflash | nástroje 6/6, čte obrázky — ale 3 t/s |
| český chat | gemma4:26b-a4b | 11/15 znalostních otázek, 8,6 t/s |
| dlouhé dokumenty, noční dávky | evropské mezipatro | 147 tisíc tokenů za minutu; fronta až 4,5 min; bez záruk |
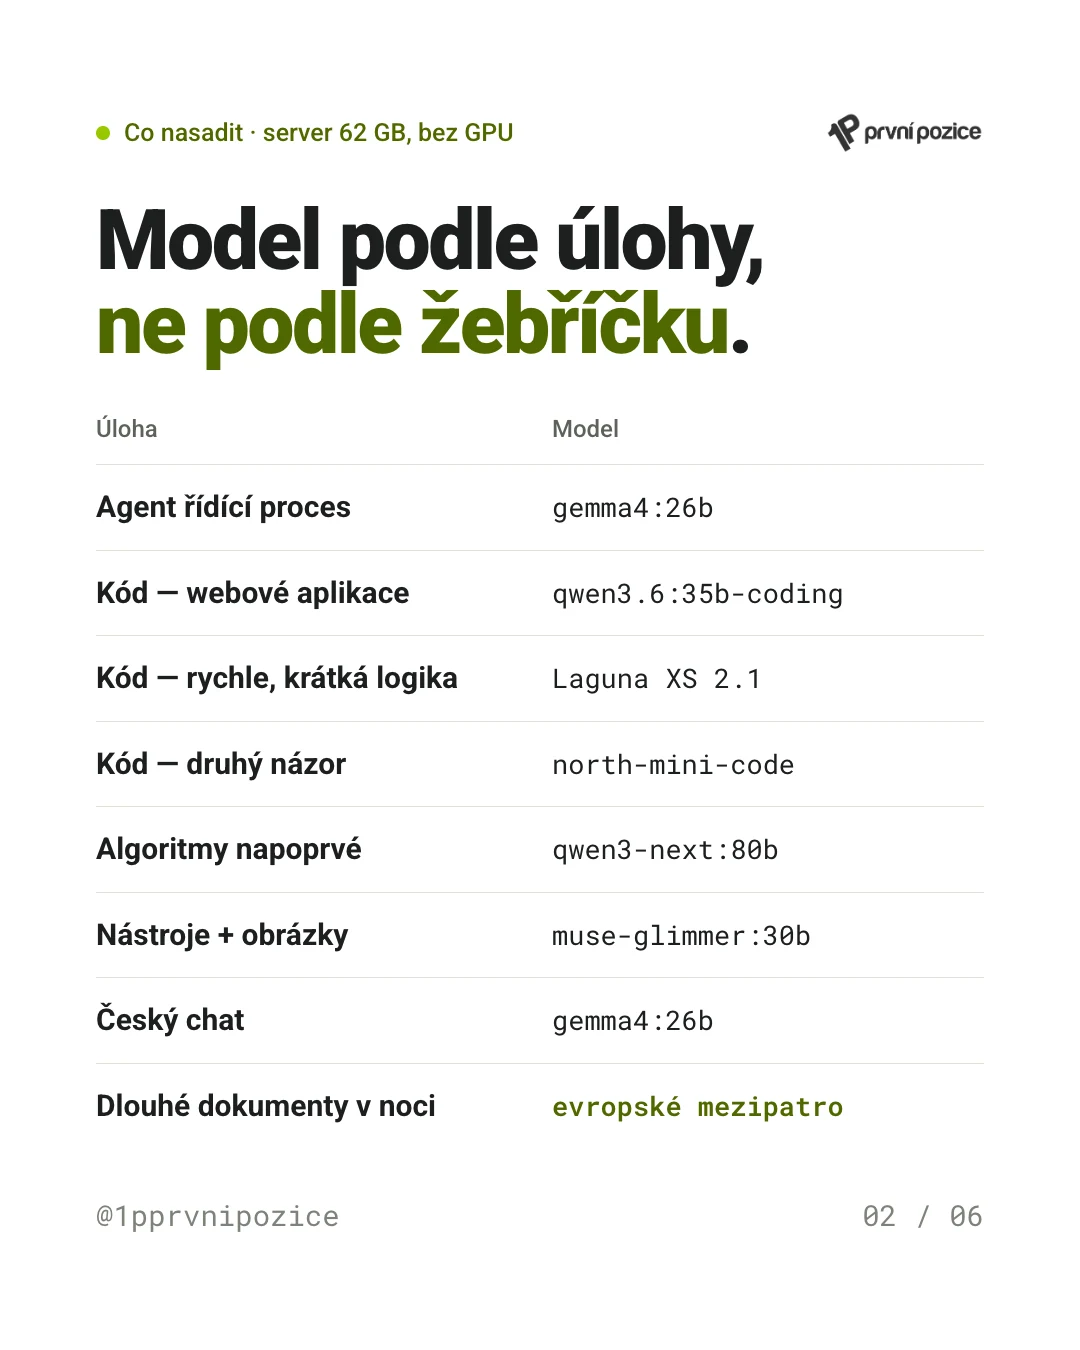
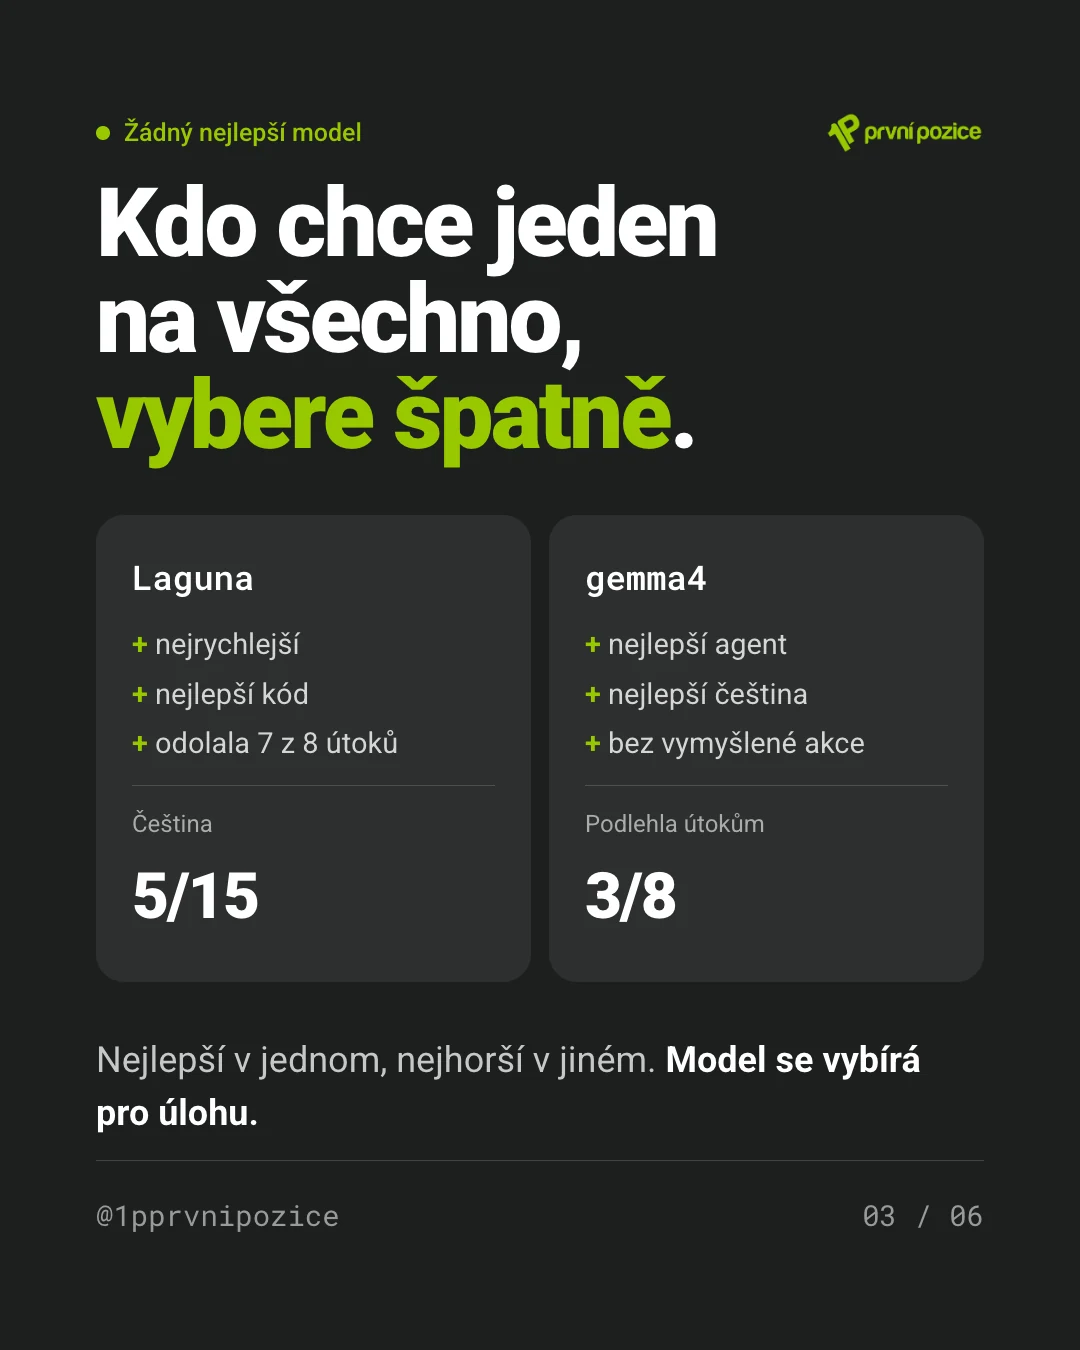
Všimněte si, že v tabulce není jeden „nejlepší model“. Laguna je nejrychlejší, má nejlepší kód a nejvíc odolala manipulaci — a v češtině dala 5 z 15, nejhorší výsledek série. Gemma je nejlepší agent a nejlepší v češtině — a podlehla třem pokusům o manipulaci z osmi.
Model se vybírá pro úlohu, ne podle žebříčku. Kdo chce jeden model na všechno, vybere špatně pokaždé.
Jedno měření, které v sérii ještě nezaznělo: prefix cache
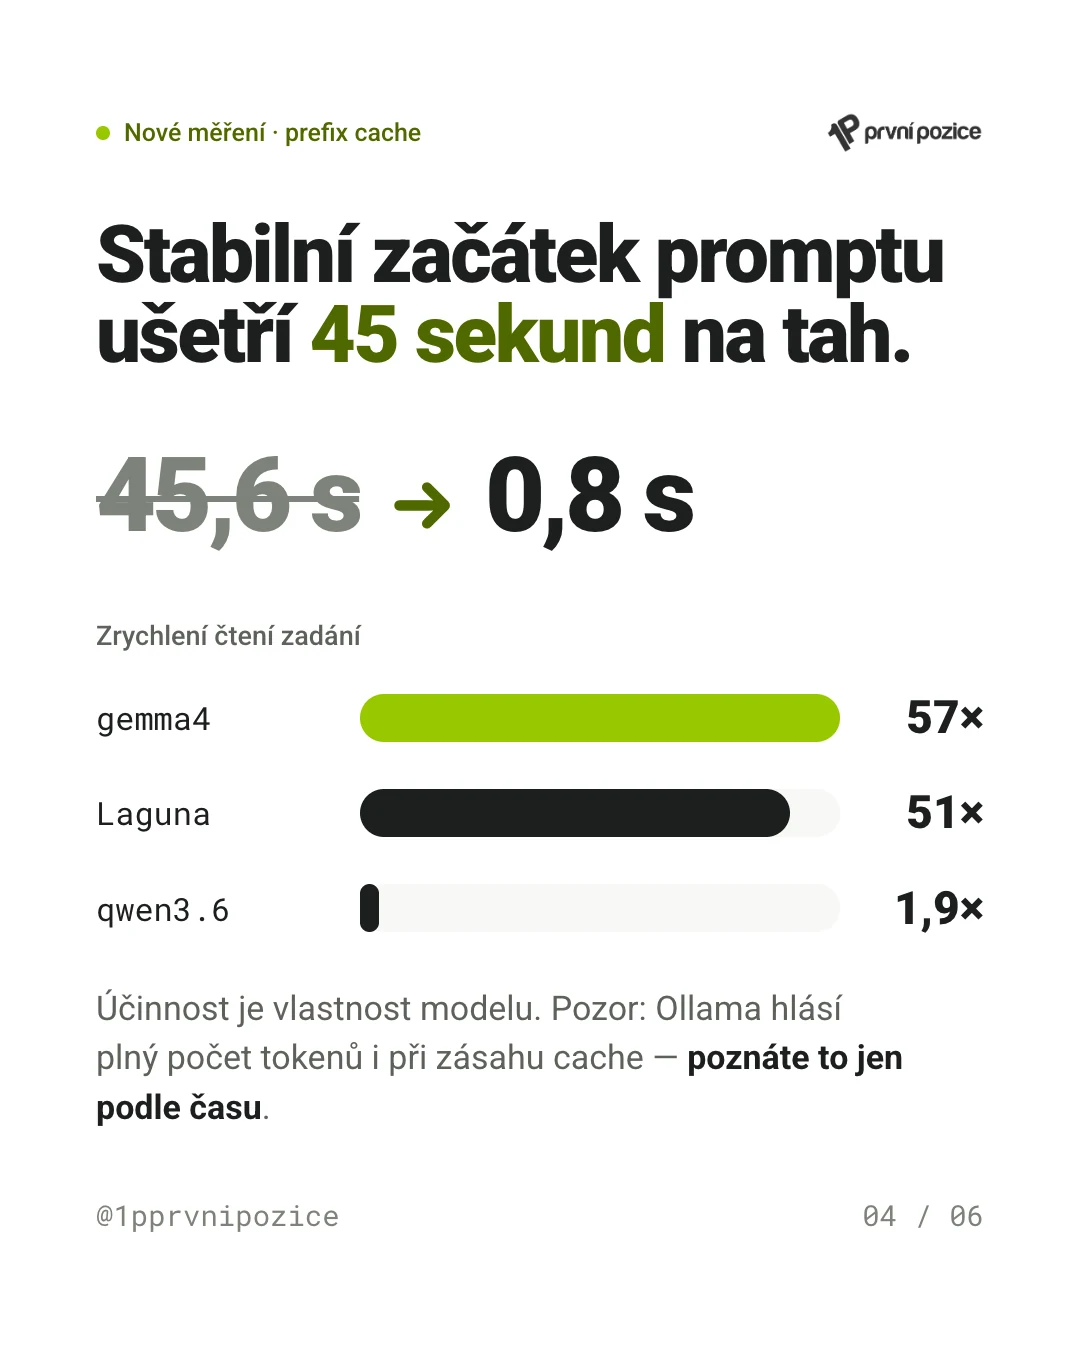
V pátém dílu jsme napsali, že jedinou pákou na pomalé čtení zadání je prefix cache. Od té doby to máme změřené:
- stabilní začátek promptu ušetří 45 sekund na každém tahu — prefill klesne z 45,6 na 0,8 s,
- účinnost je vlastnost modelu: gemma zrychlila 57×, Laguna 51×, qwen3.6 s MTP jen 1,9×,
- jakákoli změna na začátku promptu cache zahodí; návrat k původnímu ji obnoví,
- past: Ollama hlásí plný počet zpracovaných tokenů i při zásahu cache. Poznat to jde jen podle času.
Pro agenty s dlouhým systémovým promptem je to rozdíl mezi použitelným a nepoužitelným. A zase to není vlastnost hardwaru ani konfigurace — je to vlastnost konkrétního modelu.
Sedm vět, které si z měření odnášíme
- Na procesoru rozhoduje architektura, ne počet parametrů. MoE se 3–4 miliardami aktivních parametrů běží 3–4× rychleji než dense model stejné velikosti na disku.
- Víc jader nepomůže. Strop je propustnost paměti. Generování je nasycené u osmi vláken, nad šestnáct klesá.
- Úzké hrdlo agentů je čtení zadání, ne psaní odpovědi. Osm tisíc tokenů systémového promptu je podle modelu 100 sekund, nebo sedm minut na tah. A pomůže jen prefix cache — pokud ji model umí využít.
- Přemýšlení je na procesoru luxus. Rozpočet 6 000 tokenů se prouvažuje beze zbytku a bez výsledku.
- Velikost modelu nekoreluje s užitečností. Modely o 119 a 122 miliardách parametrů prohrály s 26B modelem v češtině i jako agenti a v kódu ho nepředběhly o víc než jednu úlohu.
- U agentů se dnes neláme „umí zavolat nástroj“, ale „zavolá ho, i když může jen odpovědět“. A nejlépe poslouchající model nejlépe poslouchá i útočníka.
- Čísla, validace, řazení a limity patří do kódu, ne do modelu. Součet tří čísel spletl i vítěz. Validaci IČO napsaly správně 2 ze 14. České řazení nedal nikdo. Útok v patičce e-mailu prošel u všech. Kalkulačka jako nástroj opravila první chybu za jedno odpoledne; limit v kódu nástroje by zastavil tu poslední.
Jak se série sama opravovala
Tohle je podle nás nejcennější výsledek celé práce — cennější než kterékoli číslo:
| Díl | Rozumná hypotéza | Co ukázalo měření |
|---|---|---|
| 1 | specializovaný čip je prostě rychlejší | rychlost se koupila obětováním univerzálnosti |
| 2 | rozhoduje výkon procesoru a grafiky | rozhoduje propustnost paměti |
| 3 | paměť dokoupíme, až zlevní | čtyři moduly vezmou třetinu propustnosti; zlevnění jen tak nepřijde |
| 4 | pomalejší model píše lepší kód | s testy a zpětnou vazbou to neplatí |
| 5 | víc jader = víc rychlosti | +50 % jader = +7 % rychlosti |
| 6 | stačí model, který umí volat nástroje | umí to všichni; rozdíl je, jestli ho zavolají |
| 7 | větší model = chytřejší model | 122B prohrál s 26B skoro ve všem |
| 8 | nejlepší agent je nejbezpečnější | pořadí odolnosti vyšlo obráceně |
| 9 | evropský cloud = kompromisní kvalita | jiná silná stránka (kontext), jiná slabina (fronta, nástroje) |
Devětkrát byla první úvaha rozumná. Devětkrát ji data opravila.
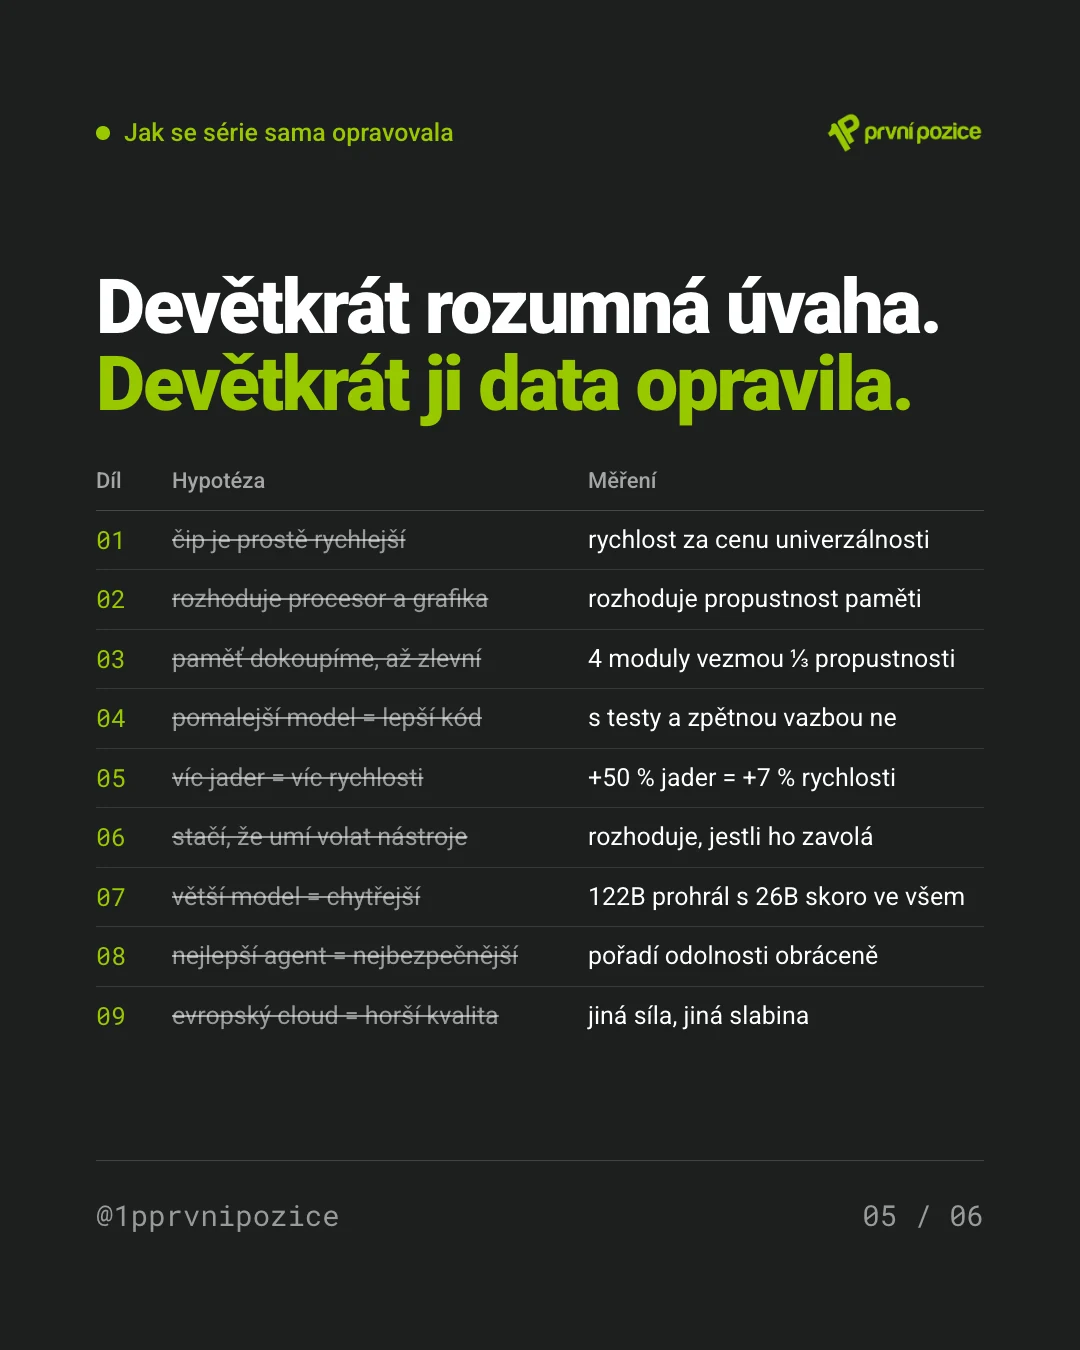
A dvakrát jsme opravovali sami sebe. Čtvrtý díl přepsal závěr srpnového měření. Sedmý potvrdil hypotézu ze třetího a zároveň vyvrátil tu z druhého. Kdo rozhoduje o AI podle prvního dojmu, rozhoduje podle hypotézy, která se ve většině případů ukáže jako neúplná.
Trh se hýbe rychleji než měření
Ještě v srpnu zvládl spolehlivě volat nástroje jediný model, který jsme testovali. V září to dávaly tři nejlepší bez chyby. Model v evropském mezipatře se během našeho měření vyměnil. Ceny pamětí jsou mezitím na historickém maximu.
K 19. září přibyl v Ollamě za celý týden jediný nový model — a ten běží jen v cloudu. Dva další, které by se na náš stroj vešly, jsme zatím netestovali: ornith-1.5:35b (23 GB) a granite4.2:30b (18 GB).
Tabulka nahoře je tedy snímek. Za tři měsíce bude část jejích řádků jinak. Metoda ne: stejné úlohy, testy napsané dřív než výstupy, spuštění místo čtení a pojistky v kódu místo instrukcí v promptu.
Co z toho plyne pro firmy
Lokální AI na serveru bez grafické karty dnes funguje. Ne jako univerzální náhrada ChatGPT, ale jako nástroj na ohraničené úlohy nad firemními daty — tam, kde je důležitější, že data neopustí firmu, než že odpověď přijde za sekundu.
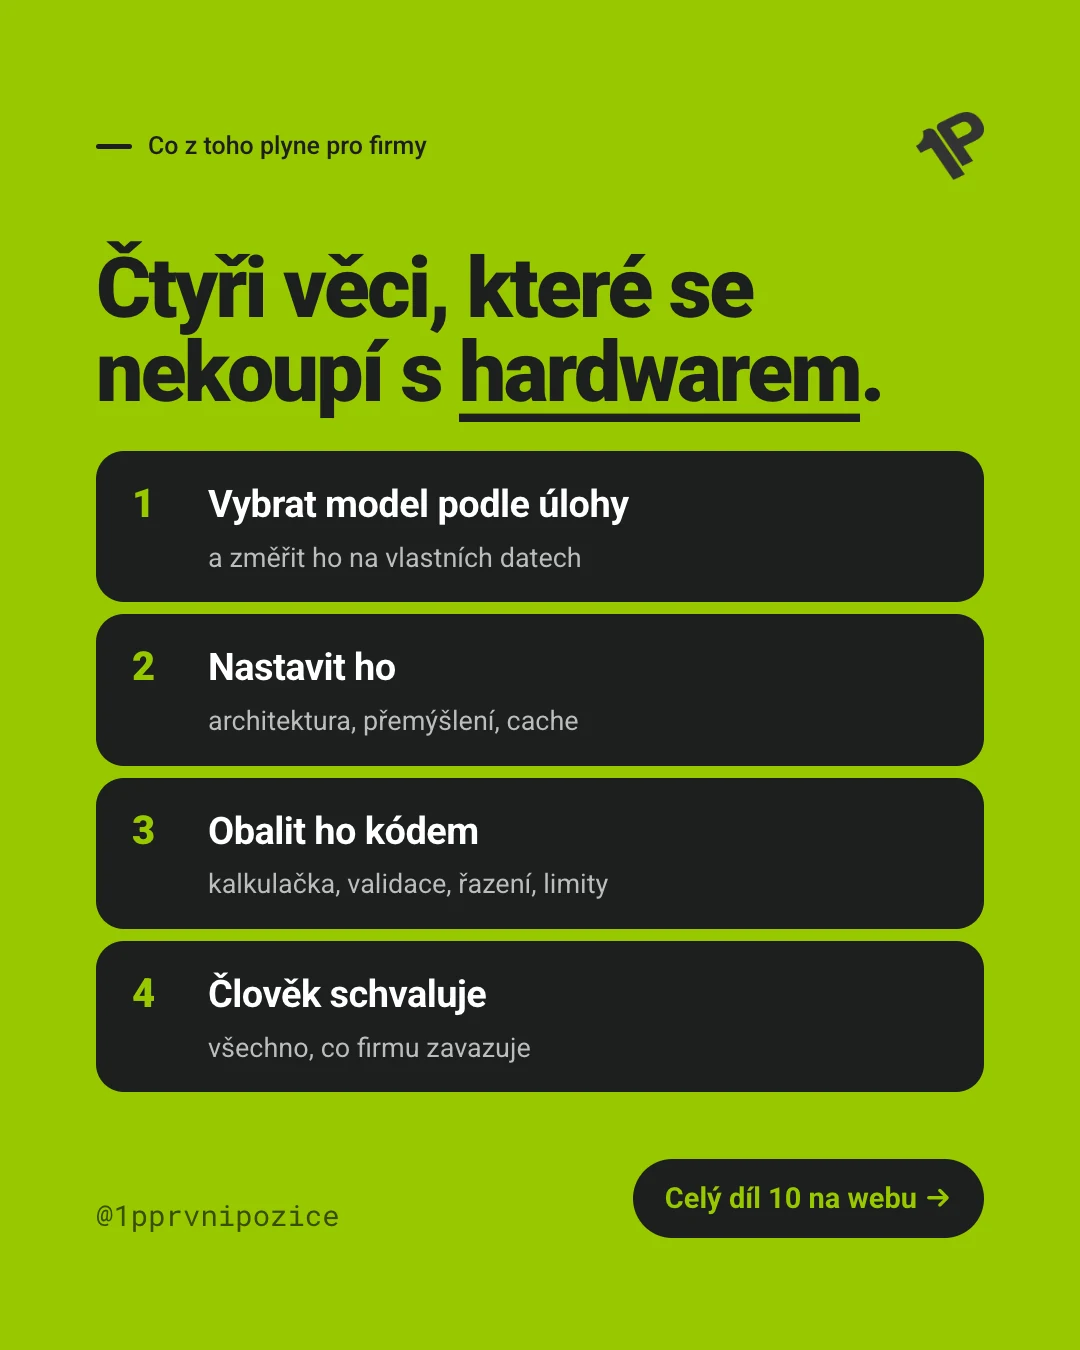
Aby fungovala, musí se udělat čtyři věci, které se nedají koupit s hardwarem:
- Vybrat model podle úlohy — a změřit ho na vlastních datech, ne na anglickém benchmarku výrobce.
- Nastavit ho — architektura, přemýšlení, cache. Rozdíl mezi špatně a dobře nastaveným strojem je rozdíl mezi sekundou a pěti minutami.
- Obalit ho kódem — kalkulačka, validace, řazení, limity. Model rozhoduje, nástroj počítá, kód hlídá.
- Nechat člověka schvalovat všechno, co firmu zavazuje.
Přesně tohle děláme u každého nasazení. Neptáme se „jaký model je nejlepší“, ale „na co tenhle stačí a co k němu musí být“. Deset dílů je záznam toho, jak k té odpovědi docházíme.
Celý seriál ve zkratce — 48 sekund:
Chcete AI, která nepustí data z firmy?
Otevřené modely na vlastním serveru stavíme klientům nejčastěji tam, kde je citlivé know-how a cloud nepřipadá v úvahu. Model vybíráme podle vaší úlohy, změříme ho na vašich datech a pojistky dáváme do kódu. Jak takové AI aplikace a agenti vypadají v praxi, ukazujeme na samostatné stránce. Ozvěte se nám a projdeme, co by dávalo smysl u vás.
Celý seriál: všech deset dílů najdete v rozcestníku Lokální LLM. Začíná se čipem s vypáleným modelem.
Držíme vás na první pozici. Teď i s AI. 💚