Víc jader nepomůže. Co na procesoru skutečně rozhoduje o rychlosti lokální AI
Když jsme serveru přidali polovinu výpočetního výkonu, jazykové modely zrychlily o sedm procent. Tak jsme přestali hádat a začali měřit: dvanáct modelů na stejném zadání, sweep počtu vláken, propustnost paměti a tři pasti, o kterých dokumentace mlčí. Vyšlo z toho, že skoro všechno, co se o rychlosti lokální AI běžně tvrdí, míří na špatné číslo.
Na čem se měřilo
Stejný server jako v minulém dílu: 62 GB RAM, 24 virtuálních jader Intel Xeon, pronajatý virtuální stroj, bez grafické karty. Ollama 0.33.2, kontextové okno 49 152 tokenů, KV cache v plné přesnosti, flash attention.
Všechna měření: přemýšlení vypnuté, teplota 0, limit 250 tokenů na odpověď, model po každém měření uvolněn z paměti.
Nejdřív jsme změřili paměť — a chytili se do první pasti
Celá série stojí na tvrzení z druhého dílu: u jazykových modelů rozhoduje propustnost paměti. Tak jsme ji změřili.
První výsledek: 206 000 MiB/s. Na pronajatém virtuálu bez grafické karty víc než dvojnásobek toho, co má dvoukanálová DDR5 v desktopu. Nesmysl.
Problém byl v nástroji. Sysbench s výchozí velikostí bloku 1 MB neměří paměť, ale procesorovou cache — stroj hlásí 64 MB L2 a 256 MB L3, takže se celý testovací blok vejde dovnitř. Aby měření sahalo na skutečnou RAM, musí být blok větší než 1 GB.
Po opravě, medián z pěti běhů:
| Test | Propustnost |
|---|---|
| čtení, 1 vlákno | 7,6 GiB/s |
| čtení, 16 vláken | 80 GiB/s (rozptyl 70–102, sdílený hostitel) |
| zápis, 16 vláken | 26 GiB/s |
| memcpy, pole 4 GB | 4,5 GiB/s |
Osmdesát gigabajtů za sekundu při šestnácti vláknech. To je zhruba úroveň dvoukanálové DDR5-5600 v běžném desktopu, kterou jsme ve druhém dílu počítali na 89,6 GB/s — a je to strop, o který se všechno další rozbije.
Dvanáct modelů, jedno zadání
Čtyři úlohy pro každý model. Decode je rychlost generování, prefill je rychlost zpracování vstupu, TTFT je čekání na první token při 1 400tokenovém promptu.
| Model | Architektura | RAM | Decode | Prefill 1,4k | TTFT |
|---|---|---|---|---|---|
| gemma4:26b-a4b | MoE, 4B aktivních | 18 GB | 8,6 t/s | 77 t/s | 18 s |
| gpt-oss:20b | MoE, 3,6B aktivních | 14 GB | 8,2 | 84 | ~10 s |
| qwen3-next:80b-a3b | MoE, 3B aktivních | 51 GB | 8,1 | 53 | 27 s |
| qwen3.5:9b | dense 9B | 8 GB | 6,0 | 70 | 19 s |
| qwen3.6:35b-a3b-mtp | MoE, 3B + MTP | 22 GB | 5,8 | 81 | 16 s |
| nemotron-3.5-lightning:30b-a3b | MoE, 3B aktivních | 25 GB | 5,6 | 78 | 17 s |
| Mistral-Small-4-119B (Q3) | MoE | 51 GB | 5,3 | 34 | 54 s |
| muse-glimmer:30b-dflash | dense + spekulativní | 19 GB | 3,2 | 20 | 71 s |
| qwen3.5-122b-a10b (IQ3) | MoE, 10B aktivních | 48 GB | 3,0 | 20 | 66 s |
| qwen3.8:27b-mtp | dense 27B | 18 GB | 2,7 | 20 | 68 s |
| muse-glimmer:30b | dense 28B | 18 GB | 2,3 | 22 | 72 s |
| gemma4:31b-it | dense 31B | 23 GB | 1,9 | 19 | 72 s |
Z téhle tabulky vyplývají čtyři věci, které jdou proti běžné intuici.
Zjištění 1: víc jader nepomůže
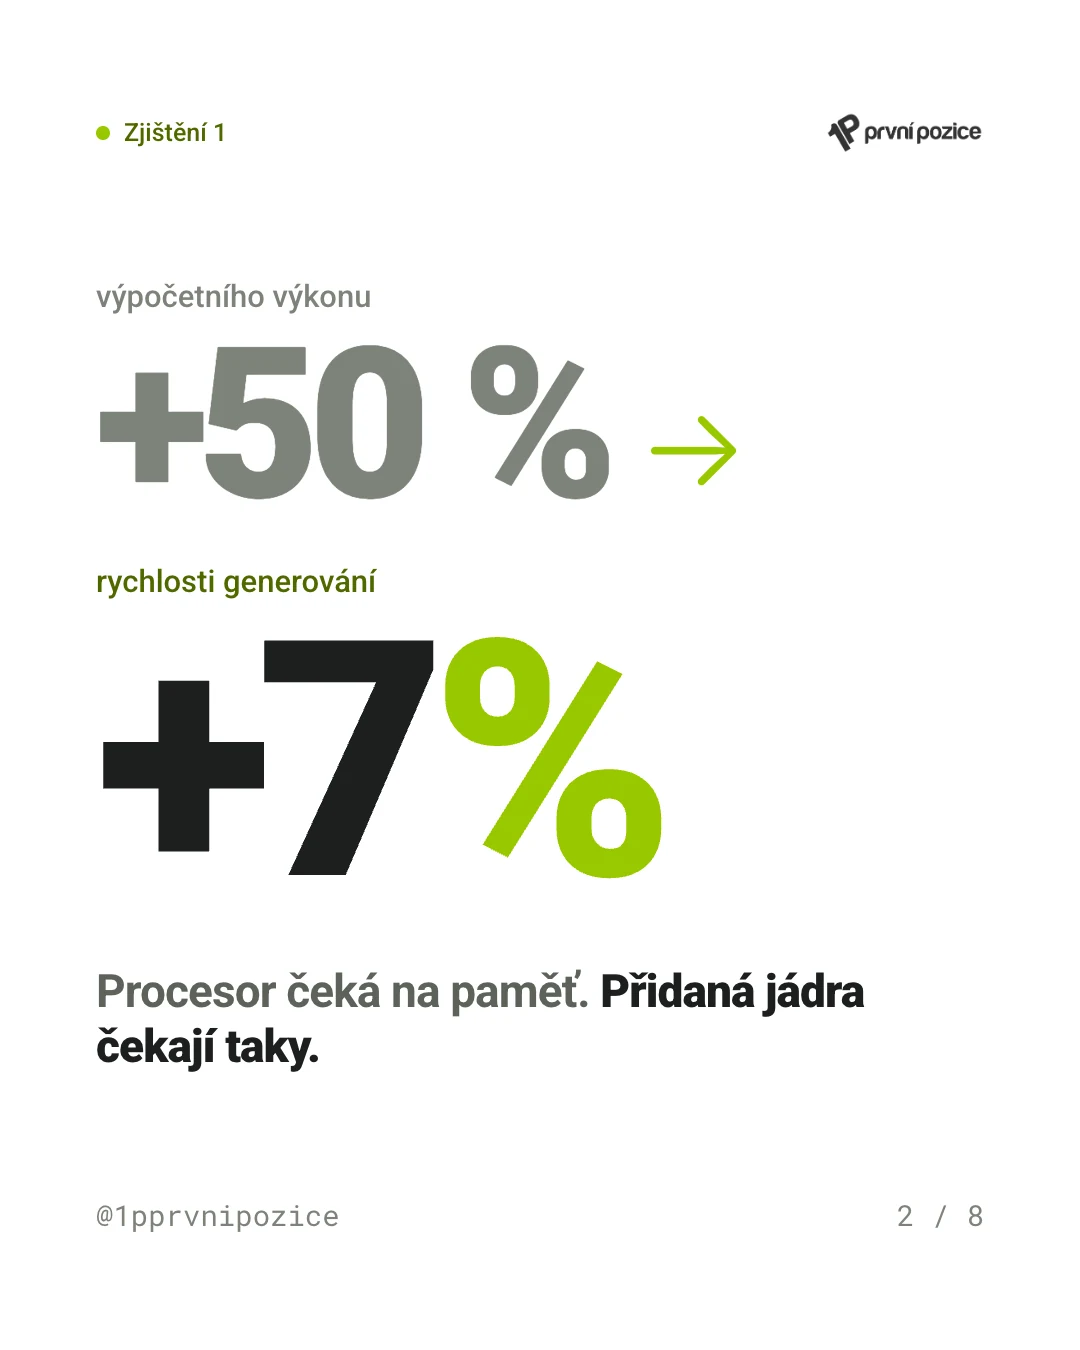
Server měl původně 16 virtuálních jader. Po navýšení na 24 — tedy o padesát procent výpočetního výkonu — zrychlil referenční devítimiliardový model z 5,6 na 6,0 tokenu za sekundu.
Sedm procent.
Abychom si to ověřili, projeli jsme na jednom dense modelu celou škálu počtu vláken:
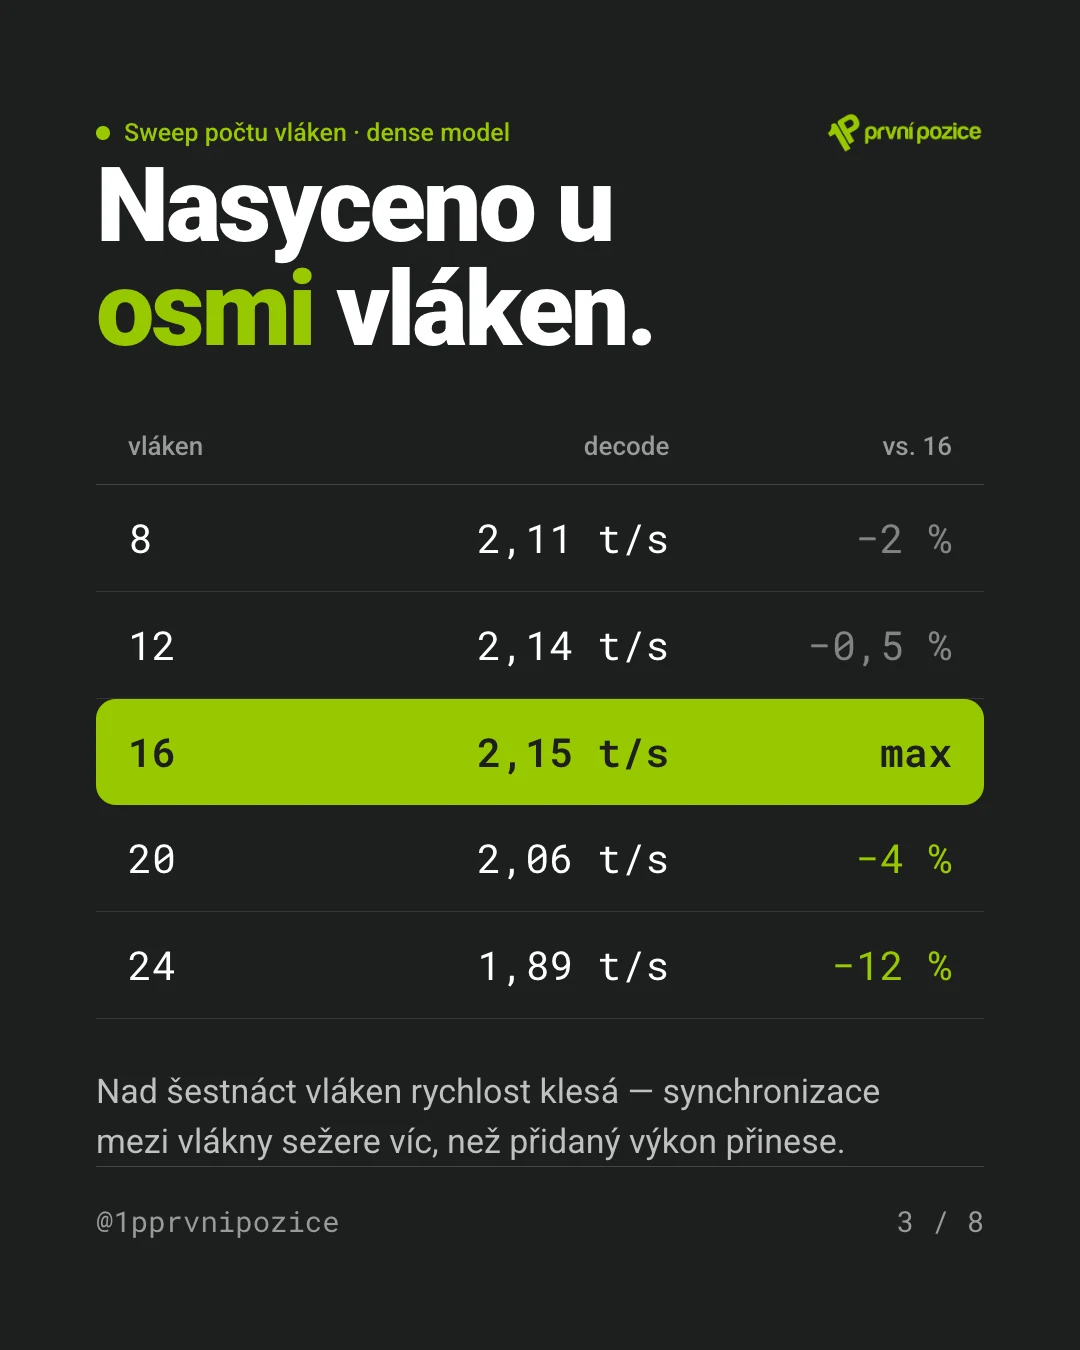
Generování je nasycené už u osmi vláken. Nad šestnáct dokonce klesá — režie synchronizace mezi vlákny sežere víc, než přidaný výkon přinese. Prefill roste do dvaceti vláken, pak taky klesne.
Důvod je ten, který jsme ve druhém dílu odvodili z propustnosti: model při každém tokenu čte většinu svých vah z paměti. Procesor stojí a čeká na data. Přidat mu jádra znamená přidat čekající jádra. Tehdy jsme to tušili z čísel na papíře — teď to máme změřené.
Pro kohokoli, kdo zvažuje lokální AI: nekupujte procesor podle počtu jader. Kupujte ho podle toho, kolik paměťových kanálů má a jak rychlou paměť utáhne.
Zjištění 2: MoE je na procesoru jediná cesta k použitelné rychlosti
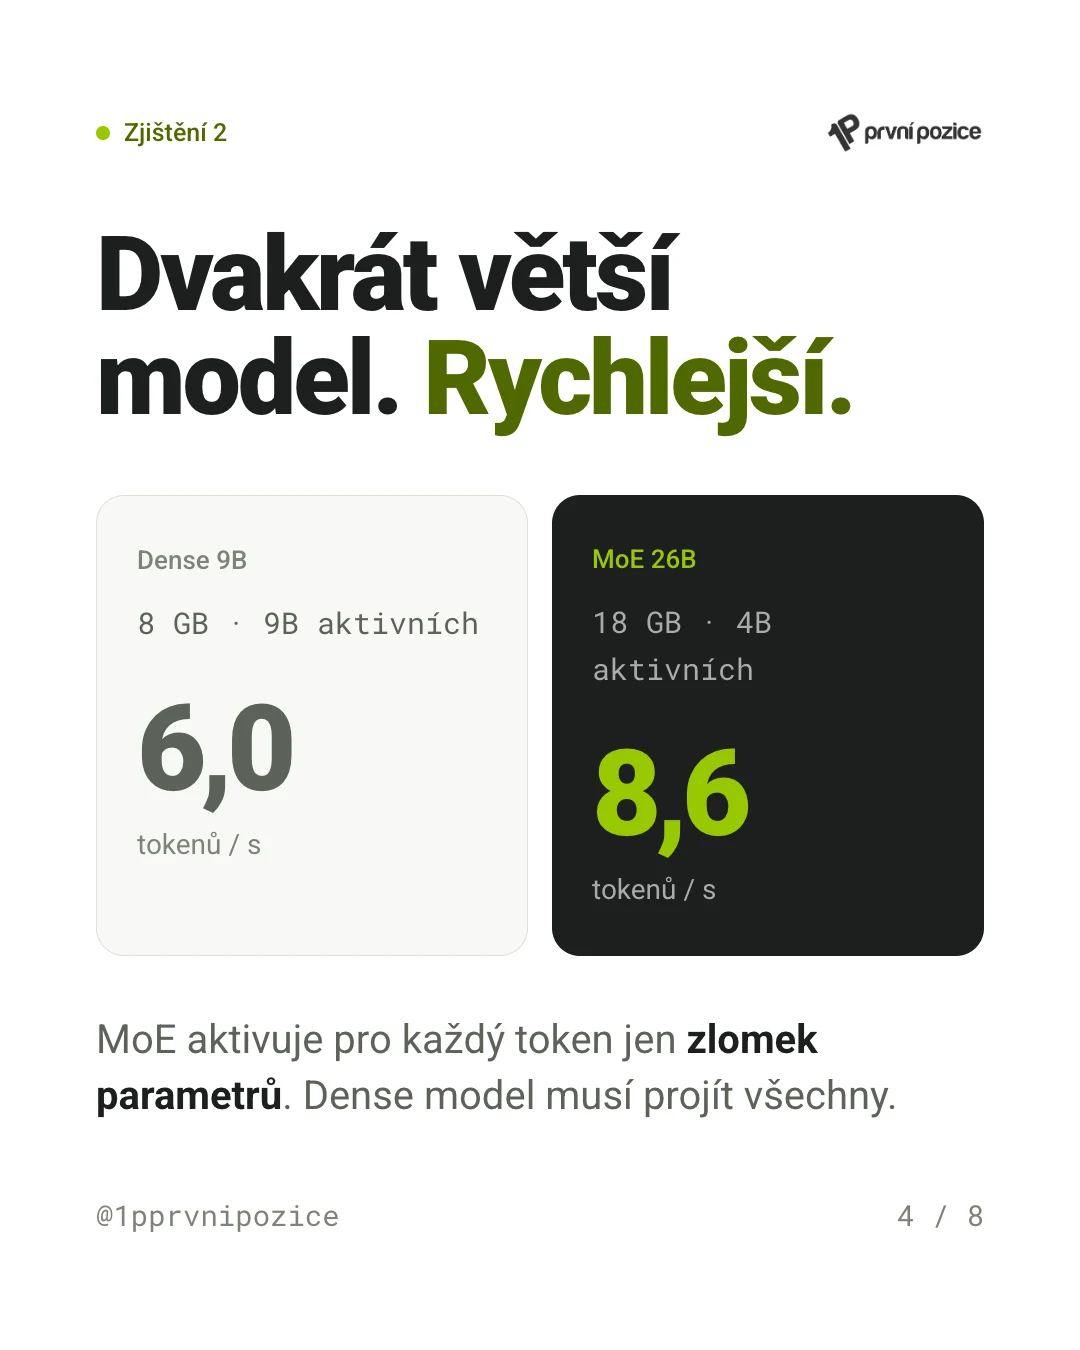
Podívejte se na tabulku ještě jednou. Osmnáctigigabajtová gemma s architekturou MoE je rychlejší než osmigigabajtový dense model — model více než dvakrát větší na disku běží rychleji.
Protože z těch osmnácti gigabajtů se pro každý token použijí jen čtyři miliardy aktivních parametrů. Dense model musí projít všech devět.
A opačně: dense modely o 27 až 31 miliardách parametrů spadnou na 2 až 3 tokeny za sekundu. Co je horší, jejich prefill klesne na zhruba dvacet tokenů za sekundu. Na 1 400tokenový prompt čekáte přes minutu, než se objeví první písmeno.
Ve třetím dílu jsme MoE popsali jako zajímavou možnost. Po tomhle měření to formulujeme ostřeji: na procesoru bez grafické karty je to jediná architektura, se kterou má smysl pracovat.
Zjištění 3: prefill je důležitější než decode
Většina benchmarků, které najdete na internetu, uvádí jedno číslo: tokeny za sekundu při generování. Naše měření říká, že je to menšina problému.
Agentní systémy — ty, co samy volají nástroje, čtou dokumenty a řídí procesy — mají systémový prompt o osmi a více tisících tokenech. Ten se musí zpracovat při každém tahu.
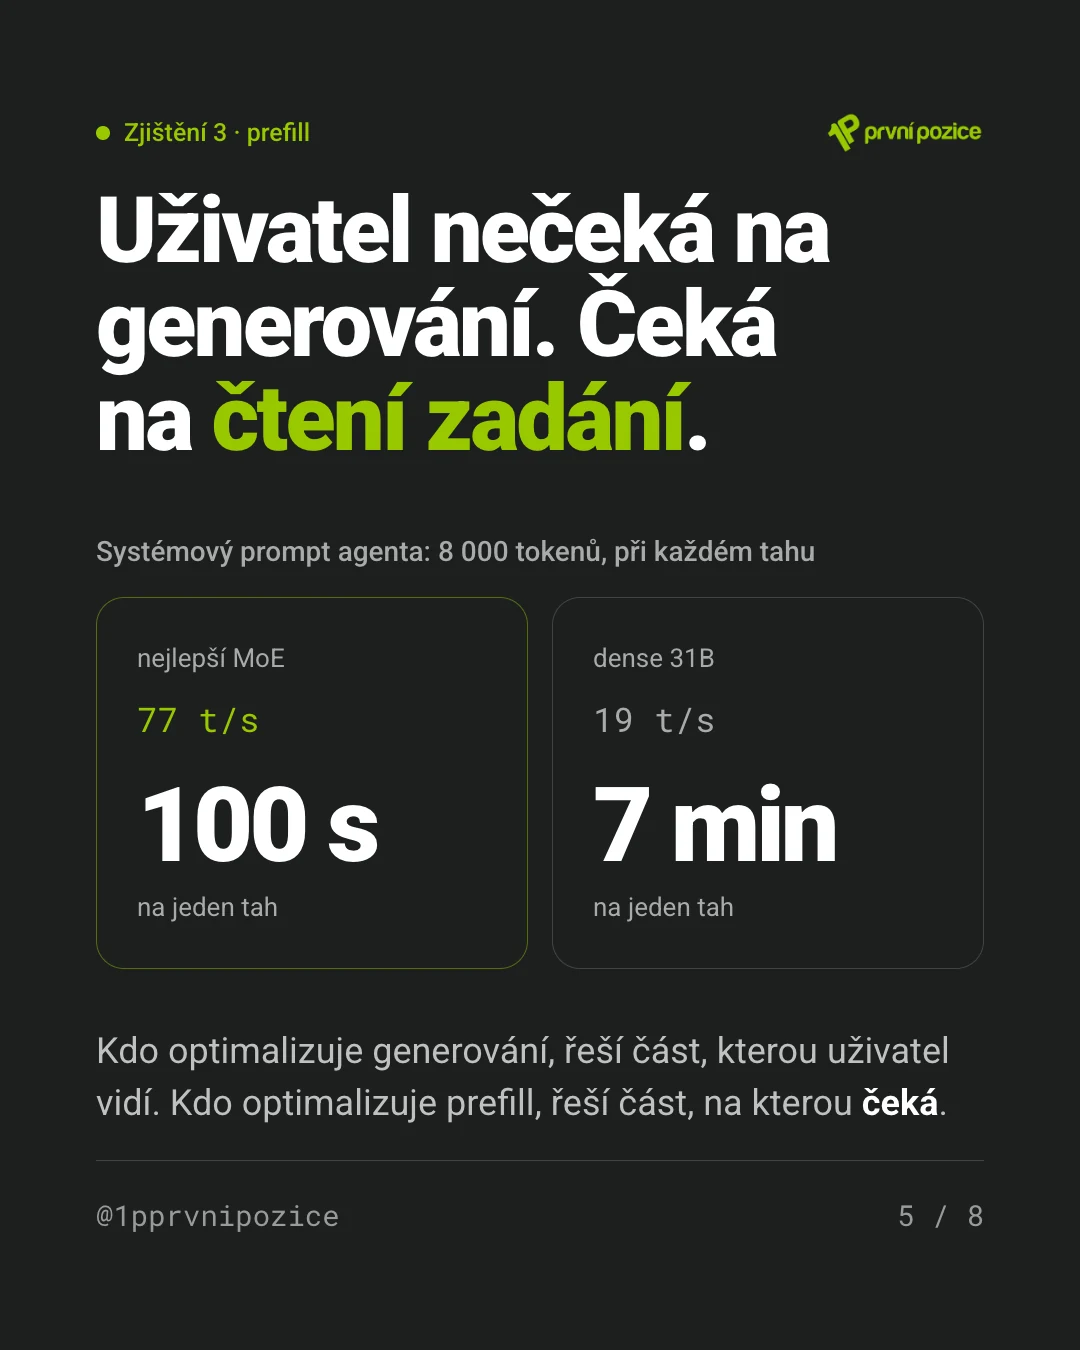
Sedm minut, než agent vůbec začne přemýšlet nad tím, co má udělat. A to při každém kroku.
Kdo optimalizuje rychlost generování, řeší část, kterou uživatel vidí. Kdo optimalizuje prefill, řeší část, na kterou uživatel čeká.
Jediná páka, která tady skutečně pomáhá, je prefix cache, o které jsme psali ve třetím dílu — aby se stejný začátek promptu nepočítal pokaždé znovu. A jedna past k ní: v létě jsme na jiném stroji zjistili, že kvantizovaná KV cache, která má šetřit paměť, stála dva a půl násobek rychlosti. Ušetřená paměť za to nestála.
Zjištění 4: jedna optimalizace pomohla, druhá ne
Multi-token prediction nepomohla. Model qwen3.6 s MTP má méně aktivních parametrů než gemma, a přesto je pomalejší — 5,8 proti 8,6. Technika, která na grafické kartě zrychluje, na procesoru nezrychlila nic.
Spekulativní dekódování pomohlo — podle typu textu. Muse Glimmer s malým pomocným modelem, který hádá tokeny dopředu:
| Úloha | Bez | S | Zisk |
|---|---|---|---|
| krátký český chat | 2,3 t/s | 2,6 t/s | +13 % |
| delší generování | 2,3 | 3,0 | +30 % |
| kód | 2,3 | 3,8 | +65 % |
Čím předvídatelnější text, tím víc pomocný model trefí. Kód je nejpředvídatelnější — a proto tam je zisk největší. Prefill se nemění.
Tři pasti okolo přemýšlení
Tohle je podle nás nejcennější část celého měření, protože o ní dokumentace mlčí.
Novější modely umějí „přemýšlet nahlas“ — před odpovědí vygenerují úvahu. Na grafické kartě je to luxus, který stojí pár sekund. Na procesoru je to jiný příběh.
Past 1: výchozí nastavení dokáže model zabít.
Devítimiliardový model má přemýšlení zapnuté z výroby. Na otázku „vysvětli ve třech větách“ vygeneroval 1 401 tokenů úvahy, než napsal první slovo odpovědi.
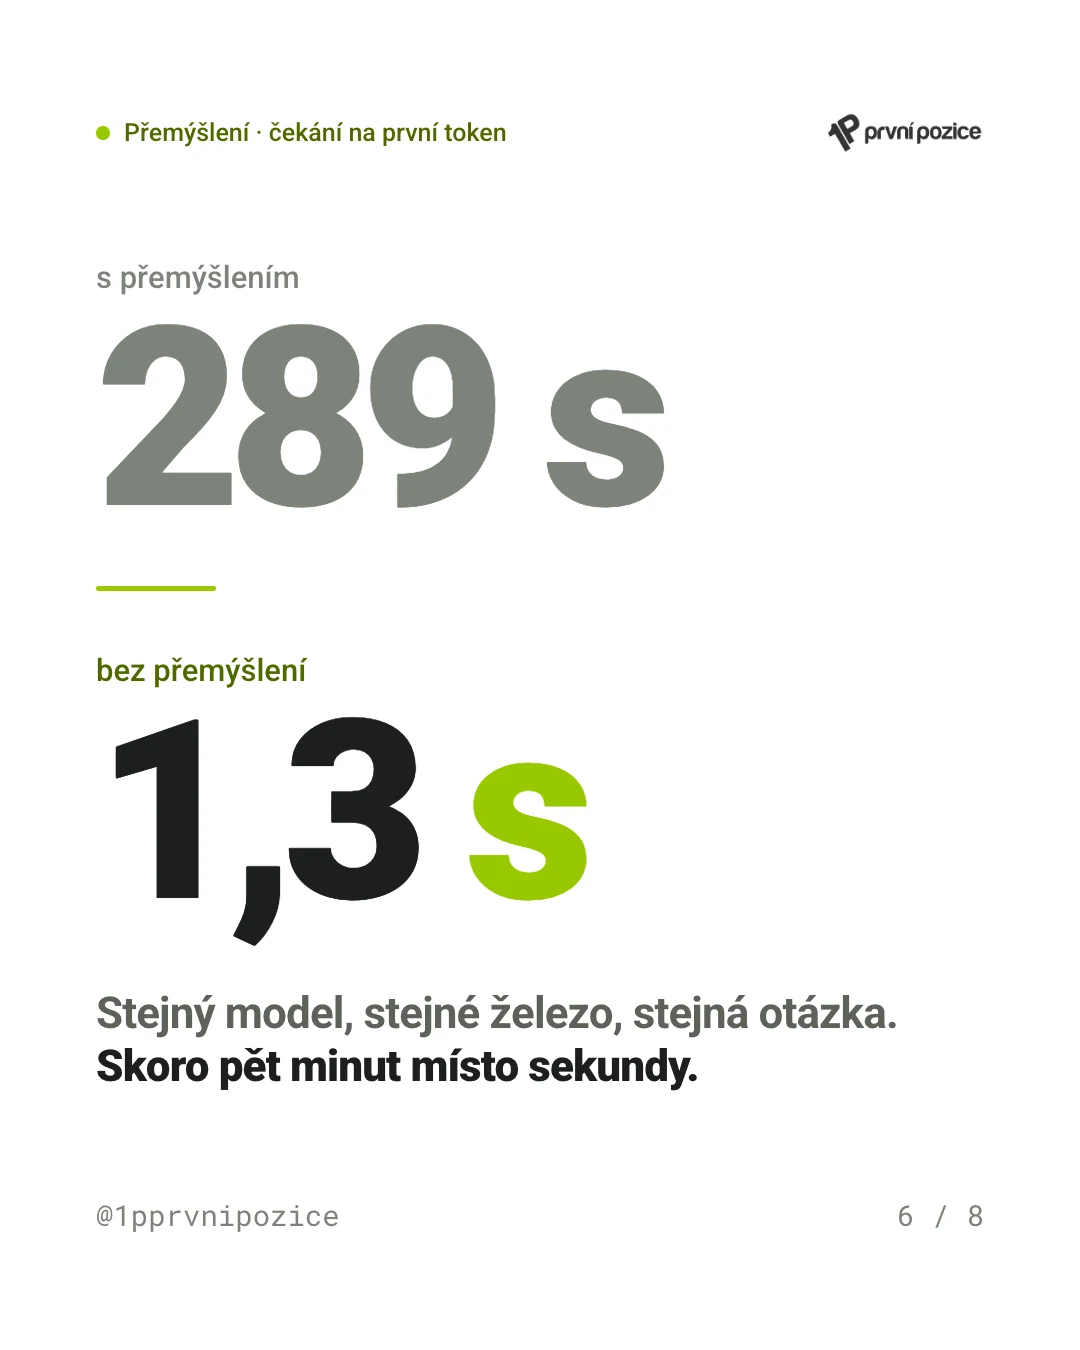
Přemýšlení nemění tokeny za sekundu. Mění jen to, jak dlouho čekáte, než se něco začne dít. Skoro pět minut místo sekundy.
Past 2: „vypnout přemýšlení“ není univerzální příkaz.
Každý model si to vykládá po svém:
- jeden model příkaz ignoruje — celý rozpočet spolkne úvaha a vrátí prázdnou odpověď. Funguje až nastavení „přemýšlej málo“, pak uvažuje jednou větou a odpoví,
- jiný model u programátorských úloh přemýšlí dál, ale jeho parser úvahu zahodí — dostanete prázdný výstup a spálených 250 tokenů bez jediného náznaku, co se stalo. U českého chatu přitom tentýž model příkaz respektuje. Rozhoduje se podle typu úlohy,
- další dva modely přemýšlení nepodporují vůbec a při pokusu ho zapnout vrátí chybu.
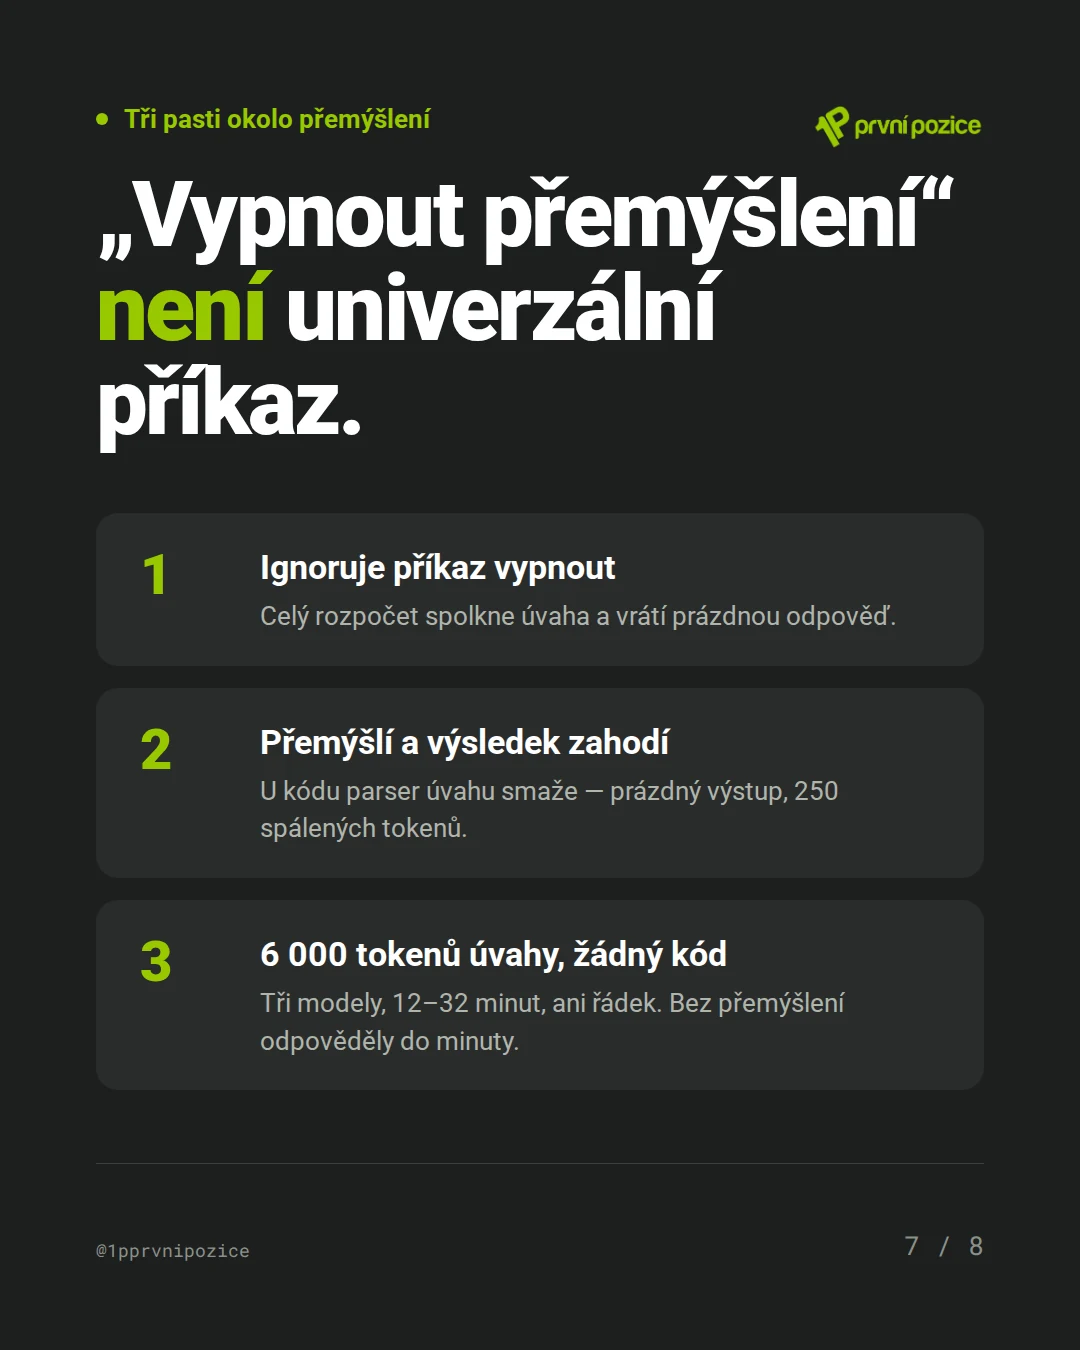
Past 3: na procesoru je přemýšlení prakticky nepoužitelné.
Tohle je ta věta z konce minulého dílu, tentokrát s čísly. Test: oprava chyby ve validaci IČO, rozpočet 6 000 tokenů, přemýšlení zapnuté.
| Model | Čas | Napsáno úvahy | Kód na výstupu |
|---|---|---|---|
| 122B | 32 min | 16 736 znaků | žádný |
| 35B MoE | 15 min | 17 598 znaků | žádný |
| 26B MoE | 12 min | 13 054 znaků | žádný |
Všechny tři prouvažovaly celý rozpočet a nedodaly ani řádek. Tytéž modely s vypnutým přemýšlením odpověděly za 18 až 71 sekund.
Co z toho plyne pro firmy
Pokud si z celého dílu máte odnést jednu věc: rychlost lokální AI nekupujete v procesoru.
Kupujete ji v propustnosti paměti, ve výběru architektury modelu a v konfiguraci, o které se v produktových listech nepíše. Přemýšlení vypnuté. KV cache v plné přesnosti. Prefix cache zapnutá. MoE model místo dense.
Rozdíl mezi špatně a dobře nastaveným strojem není deset procent. Je to rozdíl mezi „odpověď za sekundu“ a „odpověď za pět minut“ — na stejném železe, se stejným modelem.
A je to zároveň důvod, proč se lokální AI nedá nasadit z návodu. Každý z těch parametrů jsme museli změřit, protože u každého jsme původně čekali něco jiného. Víc jader mělo pomoct. Multi-token prediction měla pomoct. Vypnutí přemýšlení mělo fungovat všude.
Nic z toho neplatilo. A zjistilo se to jen měřením.
Když už to běží rychle — umí to taky pracovat?
Rychlost je vyřešená. Víme, co ji brzdí a co ne.
Ale ani jedno číslo z tohohle dílu neříká, jestli model dokáže udělat práci, kterou by ve firmě dostal člověk. Odpovědět zákazníkovi. Ověřit termín. Vytvořit rezervaci. Vědět, kdy nic nedělat.
Tak jsme napsali test, který to zkouší — agenta obsluhujícího pronájem jedné dodávky. Osm scénářů, dvanáct modelů, tvrdá kritéria.
V šestém dílu ukážeme, který model to zvládl, jakou jedinou chybu udělal — a proč ta chyba stačí, aby to nešlo pustit bez dozoru.
Chcete AI, která nepustí data z firmy?
Otevřené modely na vlastním serveru stavíme klientům nejčastěji tam, kde je citlivé know-how a cloud nepřipadá v úvahu. Jak takové AI aplikace a agenti vypadají v praxi, ukazujeme na samostatné stránce. Ozvěte se nám a projdeme, co by dávalo smysl u vás.
Souvisí: Ve čtvrtém dílu jsme kód z lokálních modelů místo čtení spustili — Vypadá správně. Nefunguje. Validaci IČO zvládly 2 modely ze 14.
Držíme vás na první pozici. Teď i s AI. 💚