Vypadá správně. Nefunguje. Co se stalo, když jsme kód z lokální AI skutečně spustili
Tři díly jsme počítali tokeny za sekundu. Pak jsme lokálním modelům zadali programátorské úlohy a vygenerovaný kód místo čtení rovnou spustili proti reálným datům. První měření dalo jasnou odpověď — a druhé, důkladnější, ji opravilo. Obě ale vedou ke stejnému závěru: chyby, které lokální modely dělají, jsou přesně toho typu, který lidské oko přehlédne.
Na čem se měřilo
Než začneme, jedna věc, na které trváme.
Druhý a třetí díl počítaly s hypotetickou sestavou — Ryzen 9 a 128 GB paměti. Tenhle díl je o skutečném měření, a to na dvou různých strojích:
- Srpen — levný VPS s 32 GB RAM a 16 vlákny procesoru. Bez grafické karty, nejnižší třída, jakou si online pronajmete.
- Září — druhý server, 62 GB RAM, 24 virtuálních jader Intel Xeon. Taky bez grafické karty, taky pronajatý.
Čísla z těchto strojů nejde míchat — a nejde je míchat ani s hypotetickým Ryzenem z předchozích dílů. U každé tabulky proto uvádíme, odkud je.
Srpen: první test a překvapivý výsledek
Začali jsme jednoduše. Čtyřem modelům jsme zadali čtyři krátké úlohy — PHP, TypeScript, PostgreSQL a Rust. Izolované funkce, jaké programátor běžně potřebuje během dne.
Tři ze čtyř modelů byly MoE architektury, o kterých jsme ve třetím dílu psali jako o cestě k rychlosti bez grafické karty. Jeden byl klasický dense, tedy pomalý.
Srpen, VPS 32 GB / 16 vláken:
| Model | Rychlost | Kvalita kódu |
|---|---|---|
| thinkingcap-qwen3.6:27b (dense) | 3,5 tok/s | nejlepší — TypeScript prošel tsc --strict čistě, Rust i SQL správně |
| gemma4:26b-a4b (MoE) | 14,1 tok/s | použitelná, ale s tichými chybami |
| qwen3:30b-a3b (MoE) | 18,2 tok/s | nepoužitelný — 4 ze 4 odpovědí uříznuté uprostřed přemýšlení |
| gpt-oss:20b (MoE) | 13,1 tok/s | nepoužitelný — prázdná odpověď, celý rozpočet padl na přemýšlení |
Pořadí kvality vyšlo přesně opačně než pořadí rychlosti. Nejpomalejší model napsal nejlepší kód. Nejrychlejší nedokončil ani jednu odpověď.
To byla ta věta, kterou jsme slíbili na konci třetího dílu. A vypadala jako zákon: pomalý dense model přemýšlí pořádně, rychlý MoE odbývá.
Jenže to nebylo to nejdůležitější, co ten test ukázal.
Validátor IČO: proč jsme kód spustili
Jedna z úloh bylo napsat validátor českého IČO. To je dobré zadání ze dvou důvodů.
Za prvé je jednoznačné. IČO má osm číslic a poslední z nich je kontrolní — spočítaná z předchozích sedmi podle pevně daného vzorce. Prvních sedm číslic se vynásobí vahami 8 až 2, sečte, a ze zbytku po dělení jedenácti se odvodí kontrolní číslice.
Za druhé se dá ověřit proti realitě. Buď kód přijme IČO existující firmy, nebo ne.
Dva modely vrátily kód, který vypadal správně. Vzali jsme ho a spustili proti skutečným identifikačním číslům.
Neuspěl ani jeden.
Model, který jinak dopadl nejlépe, kontrolní číslici úplně vynechal. Ověřoval jen formát. Odmítl 5 ze 6 platných IČO.
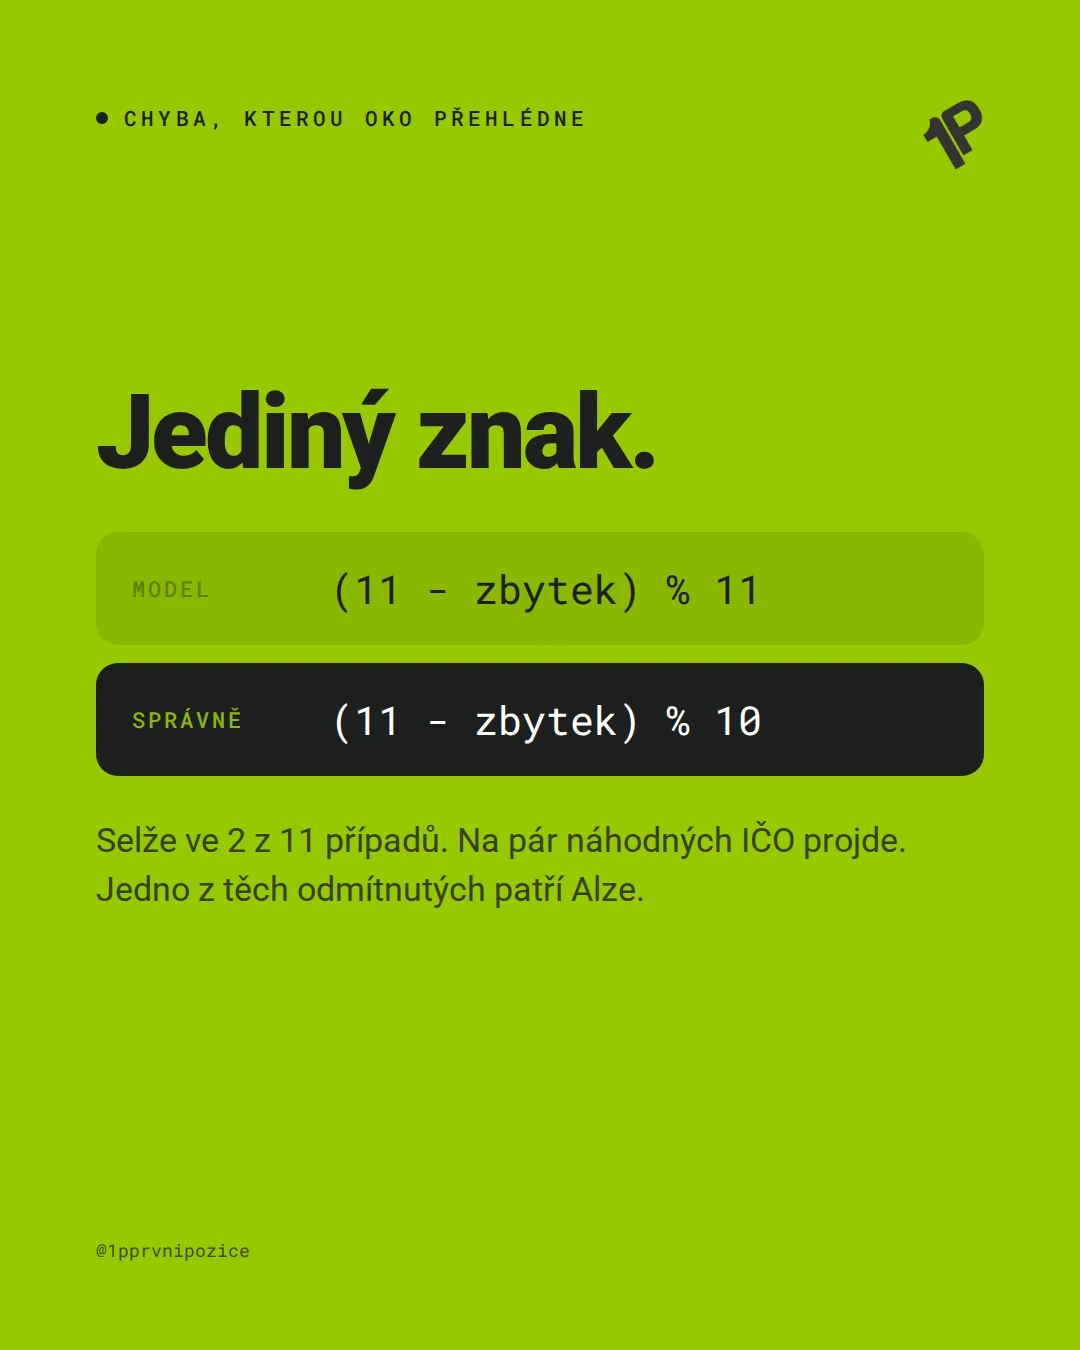
Gemma napsala výpočet téměř správně. Správný vzorec je (11 − zbytek) % 10. Gemma napsala (11 − zbytek) % 11. Jediný znak.
Ten rozdíl se projeví přesně ve dvou z jedenácti možných případů — když zbytek vyjde 0 nebo 1. Zbylých devět projde. Kdybyste kód otestovali na pár náhodných IČO, s velkou pravděpodobností by vám prošel.
Jedno z těch IČO, které Gemmin kód odmítl, patří Alze.
Proč jsme to museli změřit znovu
Srpnový test měl jednu slabinu: byl malý. Čtyři modely, čtyři úlohy, jeden stroj, hodnocení částečně ručně. Odpověď „pomalý model je lepší“ z něj vyplývala, ale stála na příliš málo datech.
Tak jsme to udělali pořádně.
Testy jsme napsali dřív, než existoval jediný výstup modelu. Každá úloha měla předem připravenou sadu kontrol, výstup se spouštěl automaticky a model dostal zpětnou vazbu jen v podobě, jakou by dostal programátor z CI: „tenhle test selhal“. Ne jak to opravit. Jen co je špatně.
Čtrnáct modelů, čtyři nezávislé testovací sady, jeden stroj, teplota 0. Všechno skriptované a opakovatelné.
Dvě z těch sad se týkají kódu. Tady jsou.
Září, sada 1: osm mini-úloh s testy napsanými předem
Krátké úlohy, kde je potřeba něco vymyslet — rozdělení zbytku při dělení splátek, zaokrouhlení DPH, detekce cyklu, parsování českých částek. Až tři kola; v opravných kolech model dostal seznam selhaných testů.
Září, server 62 GB / 24 vCPU:
| Model | Napoprvé | Nakonec | Čas |
|---|---|---|---|
| qwen3-next:80b-a3b | 7/8 | 7/8 | 5 min |
| qwen3.6:35b-a3b-coding | 6/8 | 8/8 | 9 min |
| qwen3.6:35b-a3b | 6/8 | 7/8 | 12 min |
| qwen3.5-122b-a10b (IQ3_S) | 6/8 | 7/8 | 22 min |
| gemma4:26b-a4b | 5/8 | 7/8 | 9 min |
| north-mini-code-1.0 | 5/8 | 5/8 | 5 min |
| Mistral-Small-4-119B | 5/8 | 6/8 | 13 min |
| nemotron-cascade-2 | 4/8 | 5/8 | 10 min |
| qwen3-coder:30b | 4/8 | 5/8 | 8 min |
| glm-4.7-flash | 1/8 | 2/8 | 12 min |
A tady srpnový „zákon“ přestal platit. Nejlepší výsledek napoprvé měl MoE model s 8 tokeny za sekundu. Jediný plný počet dal jiný MoE model. Pomalý dense model v téhle sadě vůbec nebyl — protože při jeho rychlosti by tři kola trvala déle, než jsme byli ochotni čekat.
Srpnový výsledek nebyl chybný. Byl jen z jiného testu. Na krátkých izolovaných funkcích bez zpětné vazby vyhrál pomalý model. S testy a opravnými koly vyhrál rychlý.
Rychlost a kvalita spolu nesouvisí tak jednoduše, jak jsme si po prvním měření mysleli. Souvisí s tím, jakou práci po modelu chcete a jak ji máte obalenou.
Lakmusový papírek podruhé
Validace IČO byla i v téhle sadě. Tentokrát napříč všemi modely.
Správně ji napsaly 2 ze 14.
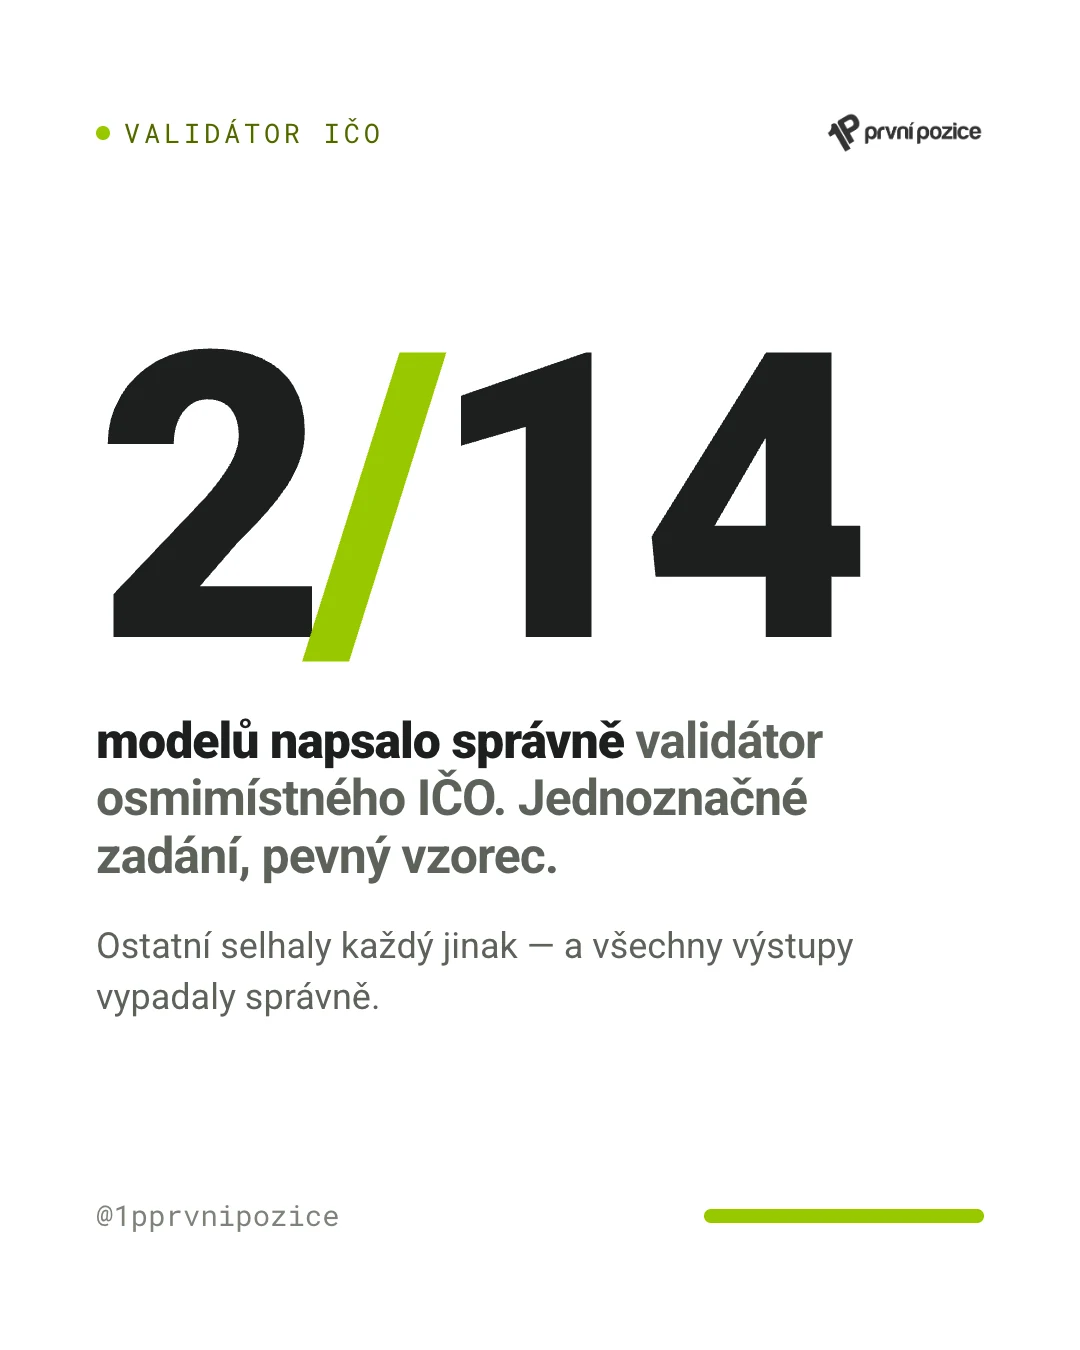
Ostatní selhaly každý jinak:
- jeden model použil elegantní zkratku „součet všech osmi číslic dělitelný jedenácti“ — matematicky skoro správně, ale padá u zbytku 0 a 1, tedy zhruba v 18 % případů,
- gemma tentokrát nesáhla po vzorci s chybným dělitelem, ale použila váhy 3, 1, 4, 1, 5, 9, 2 — číslice čísla π,
- další sčítal i kontrolní číslici a pak se ztratil ve větvení,
- další vynechal krok
11 − zbytek.
Ta elegantní zkratka stojí za zastavení. Na půl milionu reálných IČO by dala sto tisíc chybných verdiktů — včetně falešně platných. Kód přitom vypadá čistě, projde code review a na náhodném vzorku většinou projde i testy.
A ještě jedna past, která s algoritmem nesouvisí. Zadání znělo „diagnózu napiš do komentáře nad funkci“. Dva modely třikrát po sobě napsaly diagnózu jako holý text bez znaku komentáře, takže soubor nešel vůbec načíst — a to i poté, co dostaly tu chybovou hlášku jako zpětnou vazbu. Jiný model pojmenoval funkci s háčkem, ačkoli zadání jméno uvádělo bez něj.
Září, sada 2: hra v prohlížeči
Druhý test byl větší: zadání na zhruba pět tisíc tokenů, plošinovka do HTML canvasu. Výstup se spustil v prohlížeči a prošel šestnácti automatickými kontrolami. Tři kola, po každém model dostal seznam toho, co se rozbilo.
Září, server 62 GB / 24 vCPU:
| Model | Kolo 1 | Kolo 2 | Kolo 3 |
|---|---|---|---|
| qwen3.6:35b-a3b-coding | 13/16 | 13/16 | 5/16 |
| north-mini-code-1.0 | 5/16 | 15/16 | 15/16 |
| nemotron-cascade-2 | 5/16 | 13/16 | 13/16 |
| qwen3-next:80b-a3b | 12/16 | 12/16 | 11/16 |
| qwen3-coder:30b | 11/16 | 12/16 | 12/16 |
| gemma4:26b-a4b | 5/16 | 11/16 | 5/16 |
| glm-4.7-flash | 5/16 | 5/16 | 5/16 |
Tři věci, které z toho vyčteme.
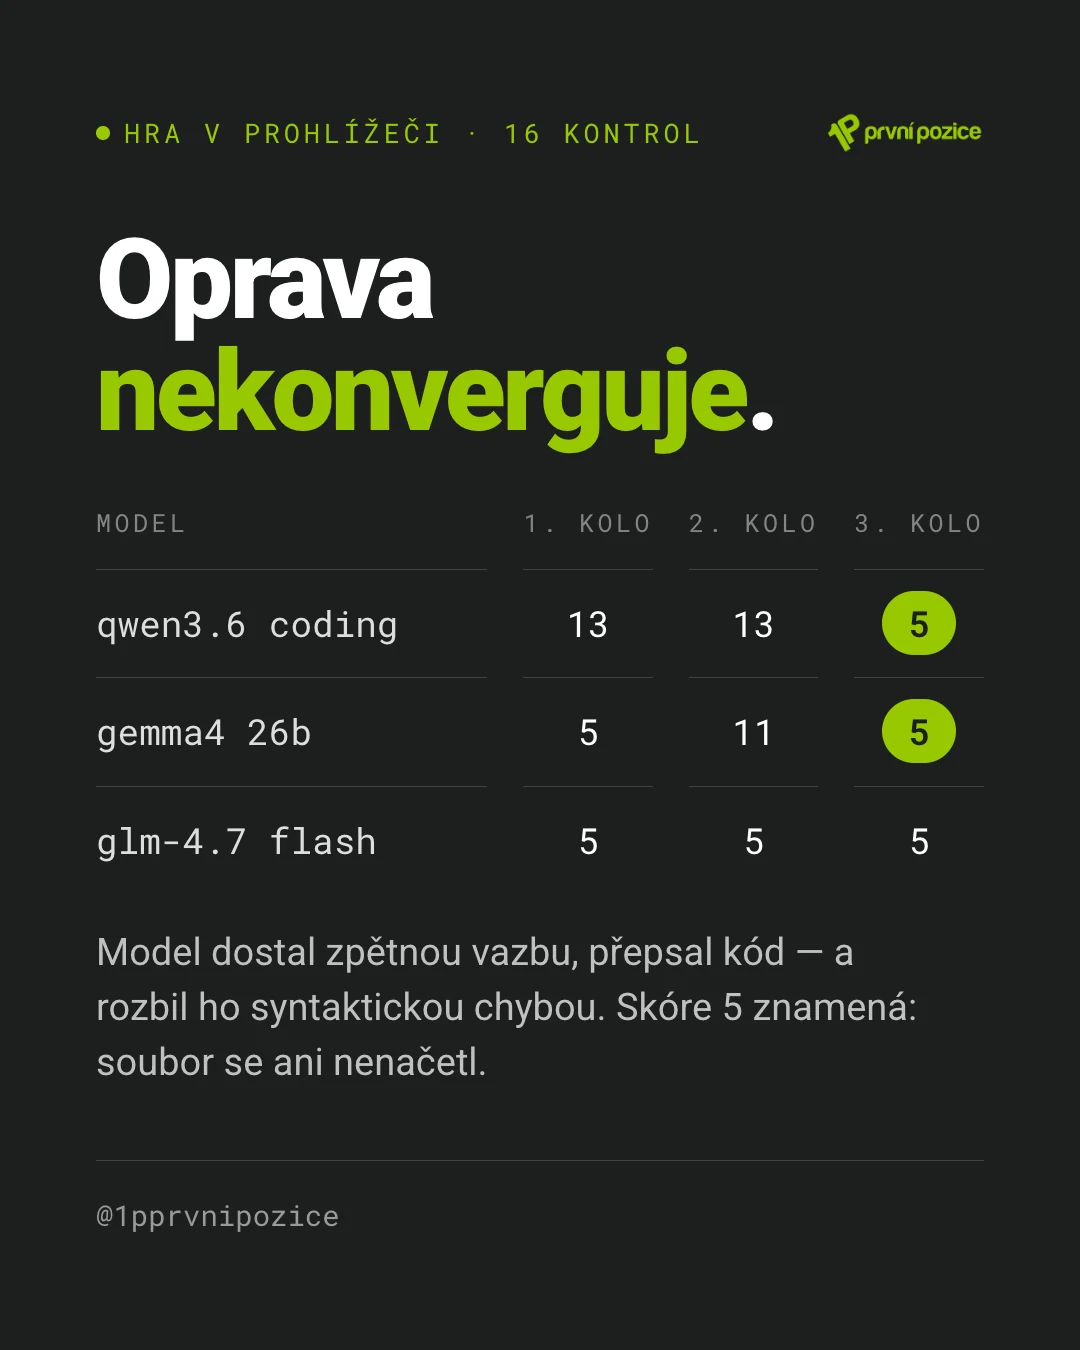
Jedna chyba zboří všechno. Skóre 5/16 v prvním kole znamená vždy totéž: syntaktická chyba nebo nedefinovaná proměnná při načtení. Zbylých jedenáct kontrol se ani nespustí. V reálném workflow s lintem by tuhle zpětnou vazbu model dostal okamžitě — a v tom je celá pointa: ten lint tam musí být.
Iterace nekonverguje. Model s nejlepší první verzí dostal zpětnou vazbu „terén a mince nejsou vidět“, přepsal kód — a vytvořil syntaktickou chybu, se kterou spadl z 13 na 5. Gemma udělala totéž: 5, 11, 5. Jiný model třikrát po sobě vrátil stejnou chybu a zpětnou vazbu ignoroval. Představa, že modelu stačí říct, co je špatně, a on to opraví, u téhle třídy modelů neplatí.
Prostorové uvažování je bariéra. Několik výstupů kreslilo postavu i terén správně — jen mimo plátno. Modely rozumí syntaxi i API, ale soustavu souřadnic a kameru nezvládají. Stejný vzorec jsme viděli už v srpnu.
Co si z toho odnášíme
Z obou měření vzešlo jedno pravidlo, které od té doby platí bez výjimky:
Kód z lokálního modelu se vždycky protáhne testem. Čtení nestačí.
Ne proto, že by lokální modely byly obecně horší. Ale proto, že chyby, které dělají, jsou přesně toho typu, který lidské oko schválí. Vzorec se správným tvarem a špatným dělitelem. Váhy, které vypadají jako váhy. Elegantní zkratka, která platí v 82 % případů.
A druhé pravidlo, které vyplynulo z rozdílu mezi srpnem a zářím:
Model se nehodnotí sám o sobě, ale spolu s tím, co ho obklopuje. Stejný model dá jiný výsledek s testy a bez nich, s lintem a bez lintu, s opravným kolem a bez něj. Kdo porovnává modely bez ohledu na to workflow, porovnává něco, co v praxi nikdy neběží.
Co to znamená pro firmy
Tenhle díl by se dal číst jako „lokální AI na kód nefunguje“. Tak ho nečteme.
Lokální model na levném serveru dnes zvládne krátké funkce, druhý názor, návrh struktury nebo první verzi něčeho, co pak projde testy. Co nezvládne, je pracovat bez dozoru — a nezvládne to ani s dozorem, pokud ten dozor spočívá v tom, že si někdo kód přečte.
To není omezení lokální AI. Je to popis toho, jak s ní pracovat. A ten popis se nedá vyčíst z benchmarku výrobce — musí se změřit na vlastní úloze, s vlastními testy, na vlastním železe.
Celá tahle série je záznam takového měření. V každém dílu byla první hypotéza rozumná. V každém dílu ji další data opravila. Tenhle díl to ukazuje nejostřeji, protože to opravilo naše vlastní zjištění z předchozího měsíce.
A rychlost? Tam nás čekalo ještě jedno překvapení
Srpnový test nás naučil nespoléhat na tokeny za sekundu. Zářijový nám ukázal, že i to, co jsme o rychlosti věděli, bylo neúplné.
Když jsme na druhém serveru zvýšili počet jader o polovinu, generování zrychlilo o sedm procent. A když jsme zapnuli režim přemýšlení, tři modely spálily rozpočet šesti tisíc tokenů a nedodaly ani řádek kódu.
V pátém dílu ukážeme, co na procesoru skutečně rozhoduje o rychlosti — a proč to není počet jader.
Chcete AI, která nepustí data z firmy?
Otevřené modely na vlastním serveru stavíme klientům nejčastěji tam, kde je citlivé know-how a cloud nepřipadá v úvahu. Jak takové AI aplikace a agenti vypadají v praxi, ukazujeme na samostatné stránce. Ozvěte se nám a projdeme, co by dávalo smysl u vás.
Souvisí: Ve třetím dílu jsme počítali, co zvládne lokální AI server bez grafické karty — kolik tokenů za sekundu a jak dlouho trvá stotisícový kontext.
Držíme vás na první pozici. Teď i s AI. 💚