Mac, AMD nebo klasické PC? U lokální AI je často důležitější paměť než procesor
Při stavbě lokálního AI serveru člověk přirozeně začne porovnávat výkon CPU a GPU. U velkých jazykových modelů ale často narazí na jiný limit: jak rychle dokáže počítač číst desítky gigabajtů vah z paměti. A právě proto jsou pro lokální AI tak zajímavé Macy s Apple Silicon i nové procesory AMD.
Ceny a konfigurace uvádíme ke stavu v srpnu 2026. U hardwaru se mění rychle, takže je berte jako orientační poměr mezi platformami, ne jako aktuální ceník.
U LLM není RAM jen otázkou kapacity
Řekněme, že máme 70miliardový model kvantizovaný na 4 bity. Jeho váhy budou zabírat řádově desítky gigabajtů. Při generování každého dalšího tokenu musí hardware pracovat s velkou částí těchto dat.
Proto může být výkon velkého LLM silně omezený propustností paměti. A tady se běžný desktop, Mac a nové AMD platformy dramaticky rozcházejí.
Běžné PC
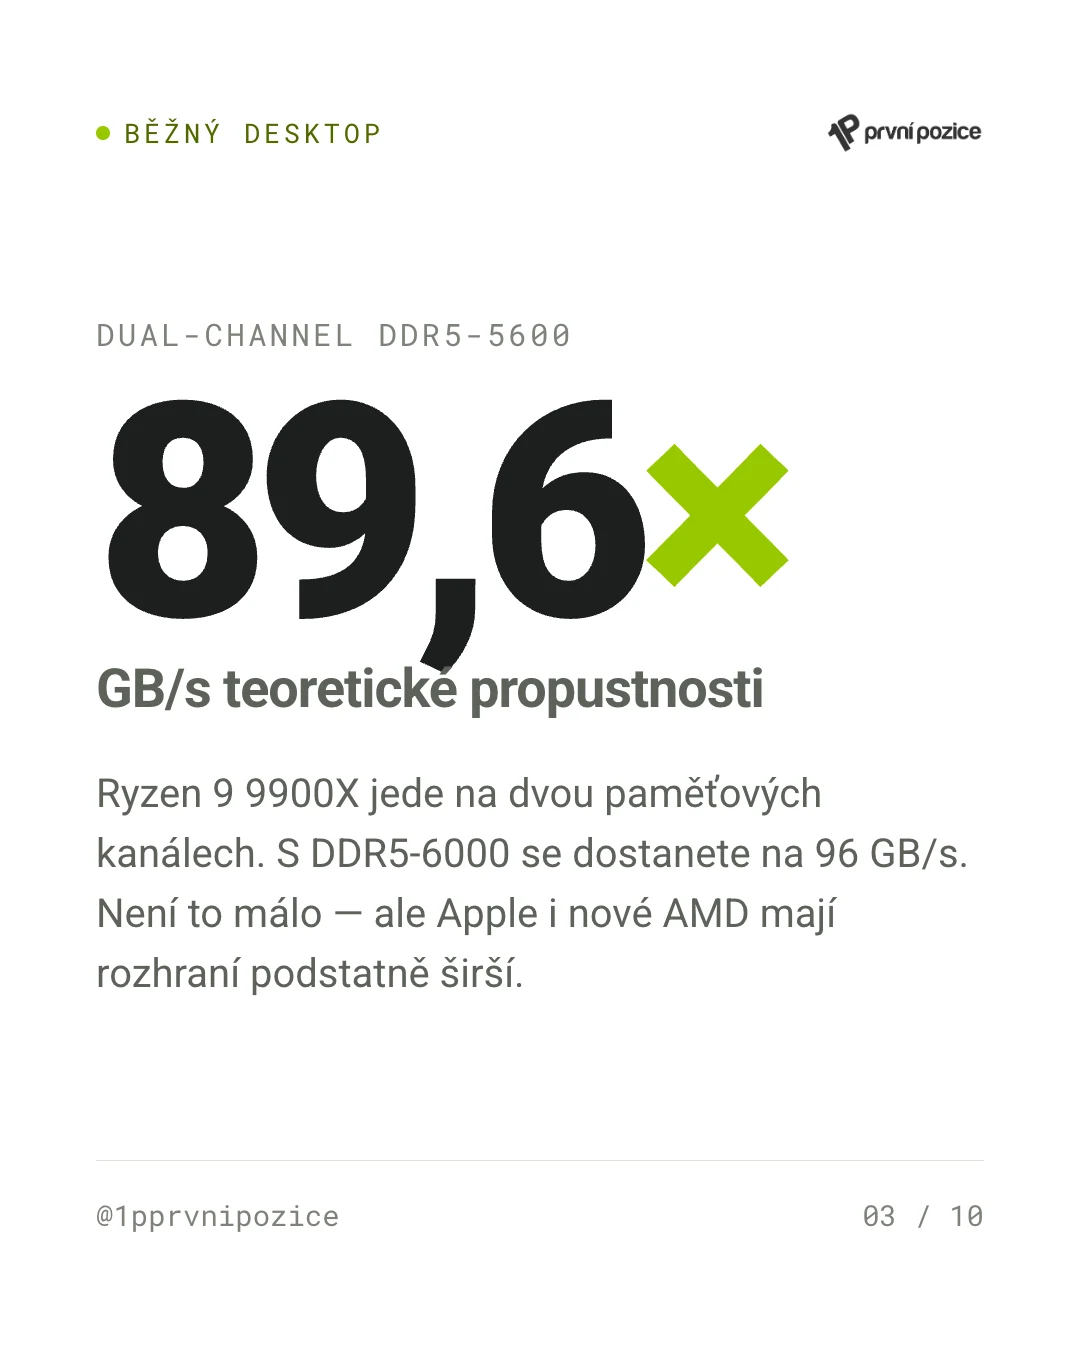
Ryzen 9 9900X používá dva paměťové kanály a AMD oficiálně podporuje při osazení dvou modulů DDR5-5600. Dvoukanálová DDR5-5600 má teoretickou propustnost 89,6 GB/s, DDR5-6000 ji zvýší teoreticky na 96 GB/s.
To není málo. Problém je, že Apple i nové mobilní AMD používají podstatně širší paměťová rozhraní.
A co dedikovaná grafická karta?
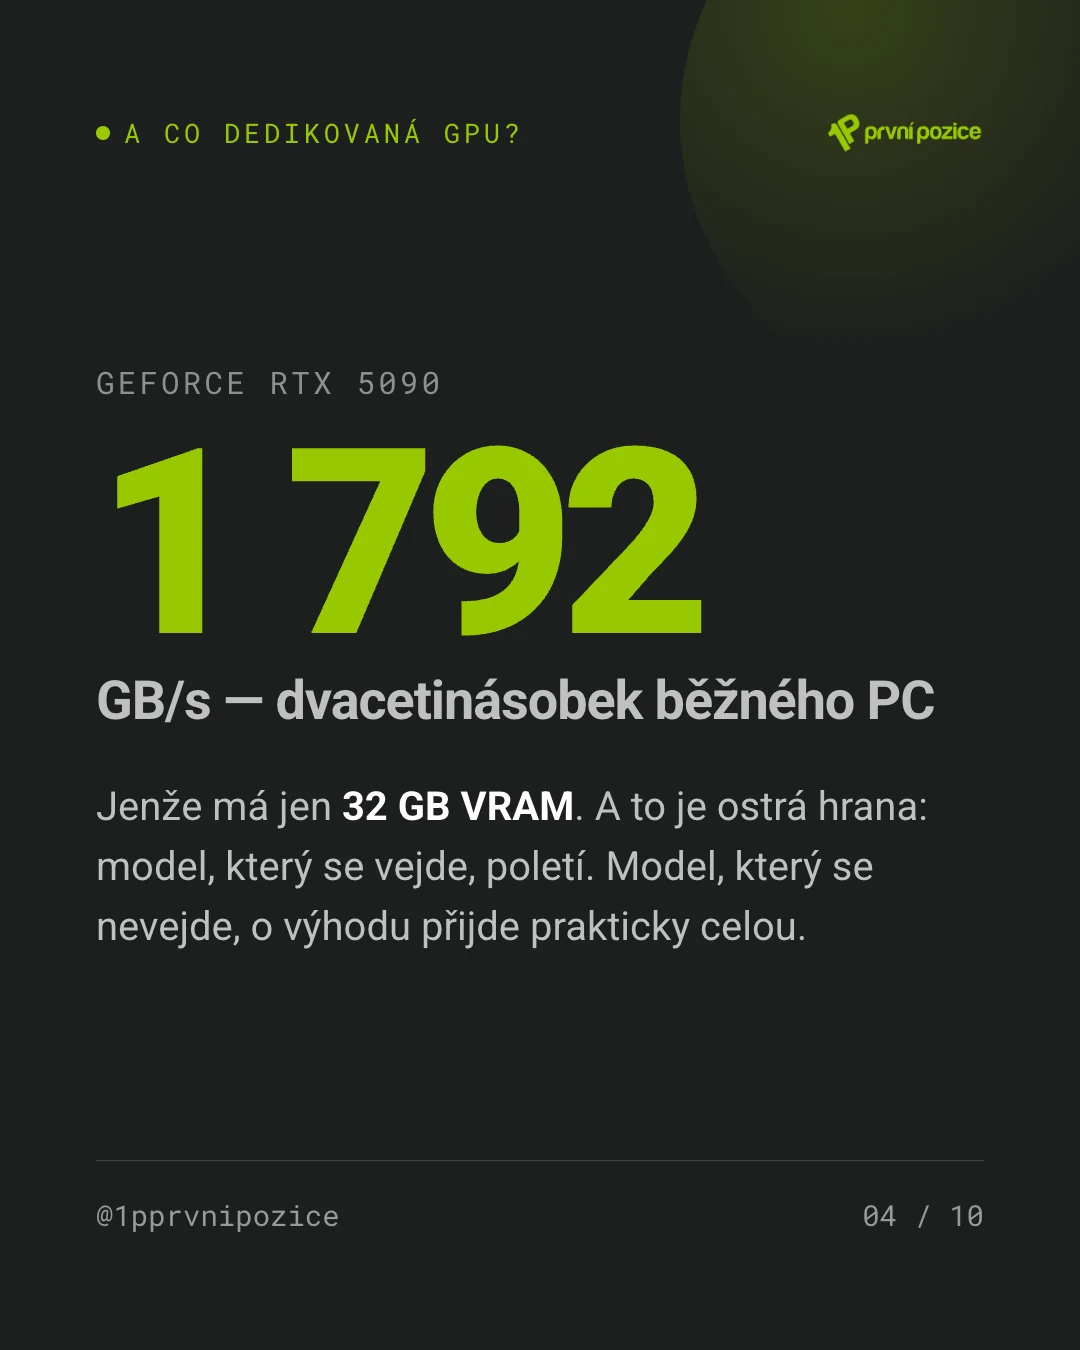
Tady je potřeba být upřímný: grafická karta vyhrává na propustnosti o celý řád. NVIDIA u GeForce RTX 5090 uvádí 32 GB paměti GDDR7 na 512bitové sběrnici s propustností 1 792 GB/s. Předchozí RTX 4090 měla 24 GB a 1 008 GB/s.
Proti 89,6 GB/s běžného dual-channel desktopu je to rozdíl zhruba dvacetinásobný. Žádná z platforem, které si ukážeme dál, se tomu ani nepřiblíží.
Má to ale jeden zásadní háček: kapacita VRAM. Model, který se do paměti grafické karty vejde, poběží nesrovnatelně rychleji než kdekoli jinde. Model, který se tam nevejde, se buď nespustí vůbec, nebo se začne přelévat do systémové paměti — a v tu chvíli rychlostní výhoda nezmizí částečně, ale prakticky celá.
Není to tedy plynulý kompromis. Je to ostrá hrana. Buď se vejdete, nebo ne.
A ta hrana je poměrně nízko. 32 GB je dnes strop spotřebitelské řady; RTX 5080 má 16 GB, RTX 5070 dvanáct. To pro model kolem 30B v kvantizaci Q4 stačí, ale nezbývá mnoho místa na dlouhý kontext a KV cache. Větší modely už jsou mimo.
A přesně proto jsou pro lokální AI zajímavé Apple a nové AMD. Obětují část rychlosti výměnou za to, že se do paměti vejde podstatně víc.
Mac mini M4 Pro
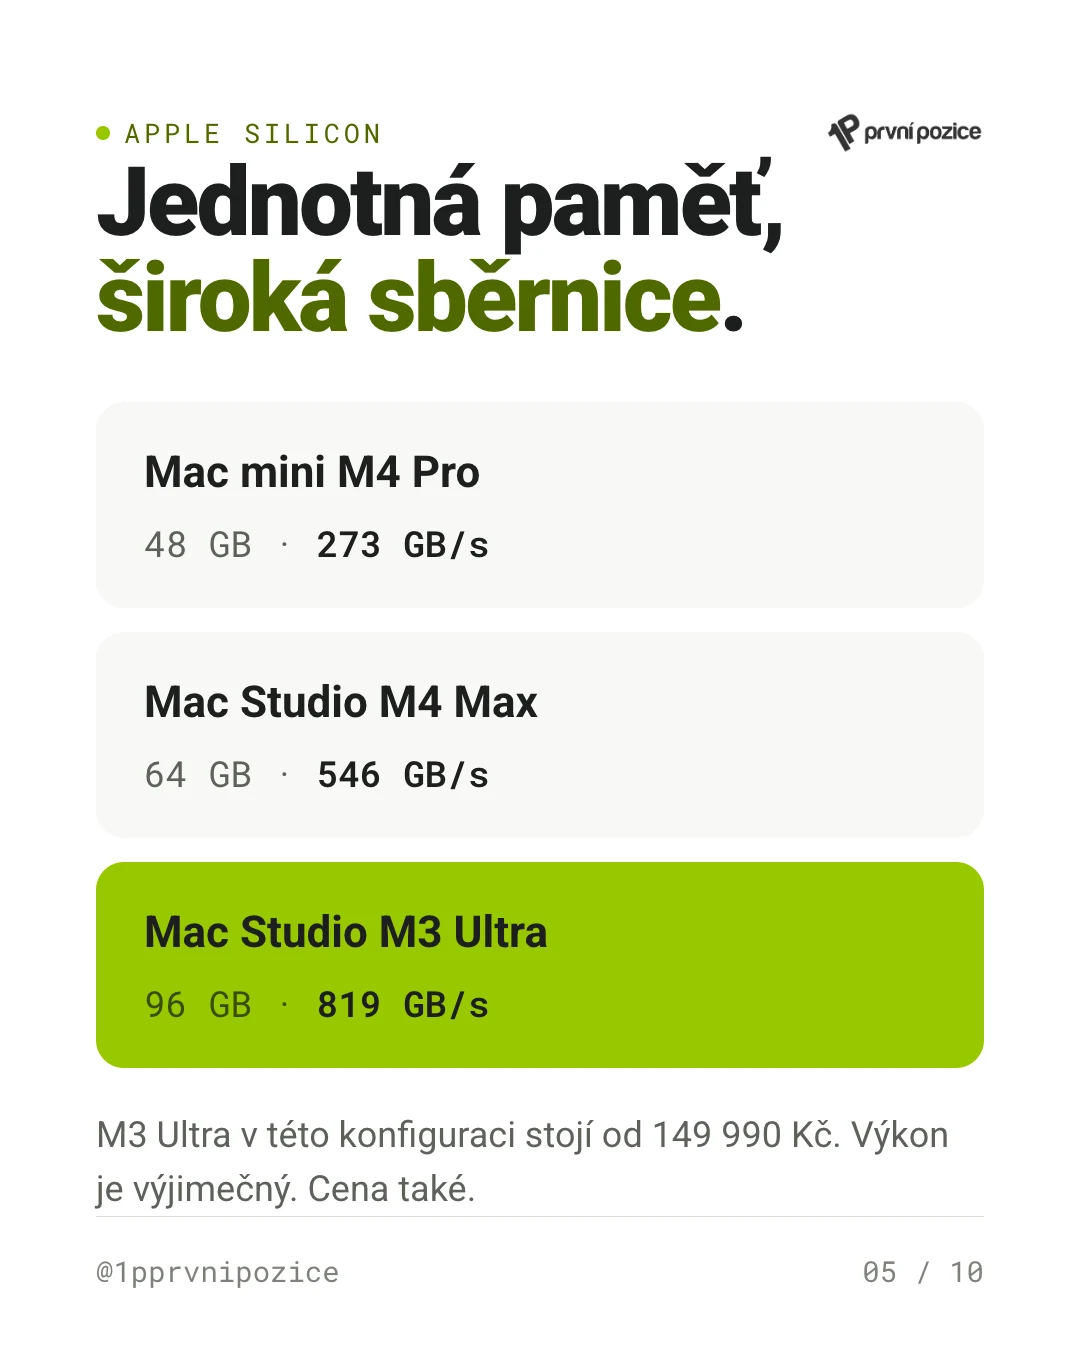
Současný Mac mini M4 Pro lze objednat až se 48 GB jednotné paměti a Apple udává propustnost 273 GB/s. To je přibližně trojnásobek teoretického bandwidthu běžného dual-channel desktopu. Navíc jde o unified memory: stejnou paměť používá CPU i GPU.
Mac Studio M4 Max
U vyššího M4 Max se 40jádrovým GPU dosahuje paměťová propustnost až 546 GB/s a současná česká konfigurace umožňuje 64 GB jednotné paměti. Apple ji aktuálně nabízí za 77 990 Kč. To už je přibližně šestinásobek teoretického bandwidthu DDR5-5600 v běžném desktopu.
Mac Studio M3 Ultra
M3 Ultra jde ještě dál: 819 GB/s, aktuálně s 96 GB jednotné paměti. Český Apple Store tuto konfiguraci uvádí od 149 990 Kč.
Výkon je výjimečný. Cena také. Pro srovnání: za tuhle jednu krabičku pořídíte několik běžných PC se 128 GB paměti. To samo o sobě neznamená, že je to špatná koupě — u některých úloh se ten rozdíl vrátí. Znamená to jen, že volba hardwaru pro lokální AI není otázka „co je nejlepší“, ale „co dává smysl pro konkrétní úlohu“.
AMD zvolilo jiný kompromis
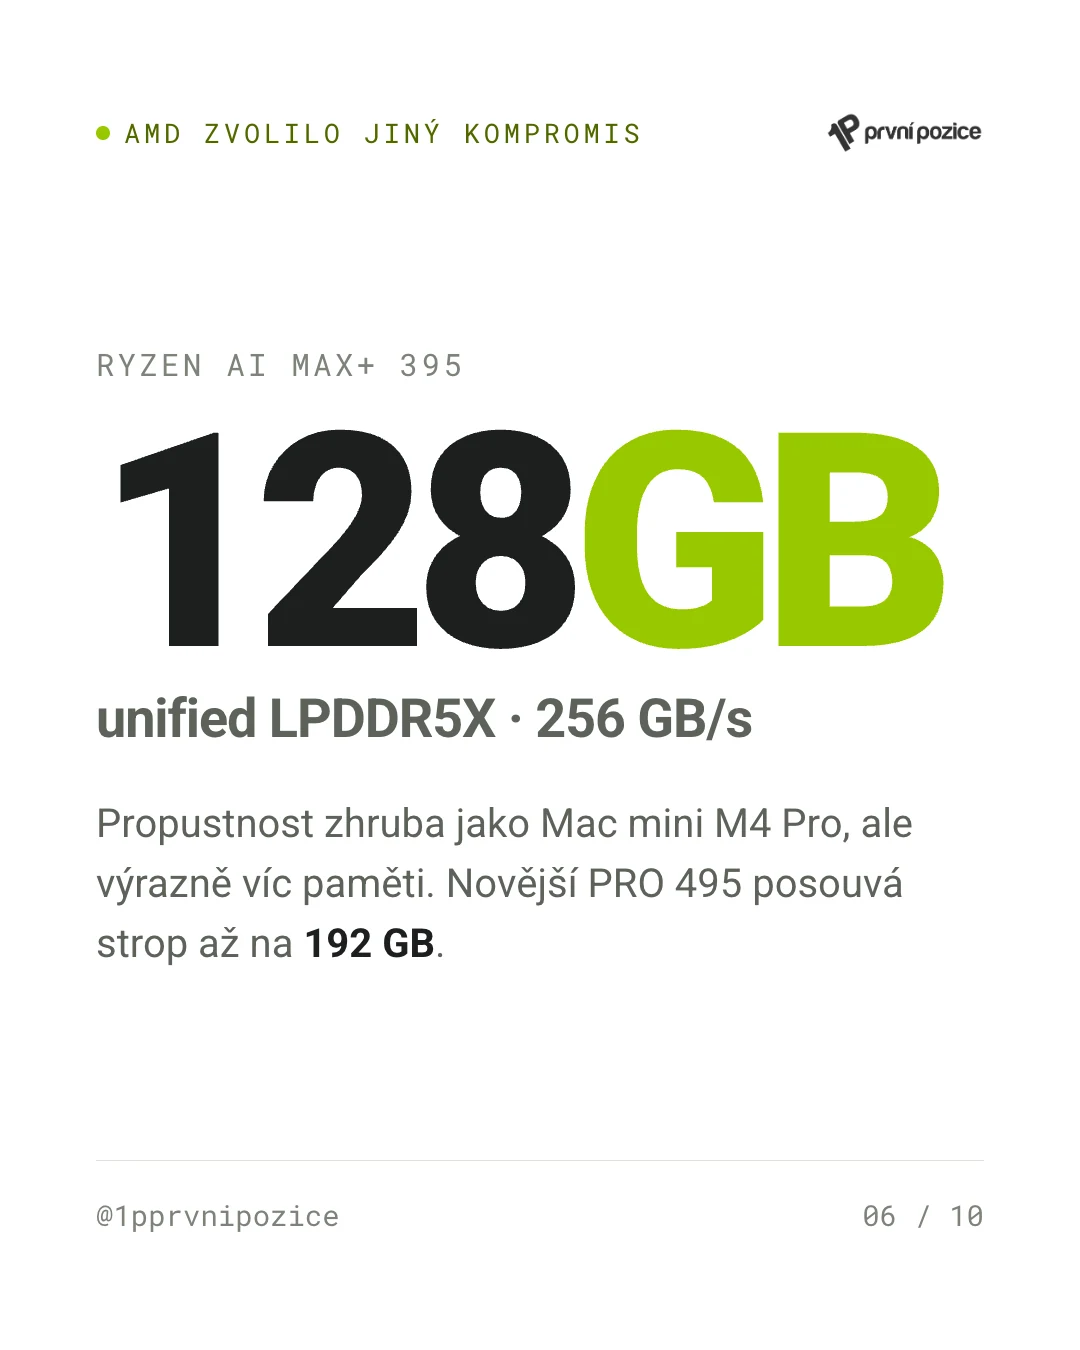
Ryzen AI Max+ 395 nabízí až 128 GB unified LPDDR5X-8000 s propustností 256 GB/s. Je tedy přibližně na úrovni Macu mini M4 Pro, ale může mít výrazně více paměti. AMD svou Halo Developer Platform dokonce přímo prezentuje jako systém pro lokální provoz modelů až kolem 200 miliard parametrů.
Novější Ryzen AI Max+ PRO 495 posouvá maximální kapacitu až na 192 GB, stále však používá 256bitovou LPDDR5X sběrnici.
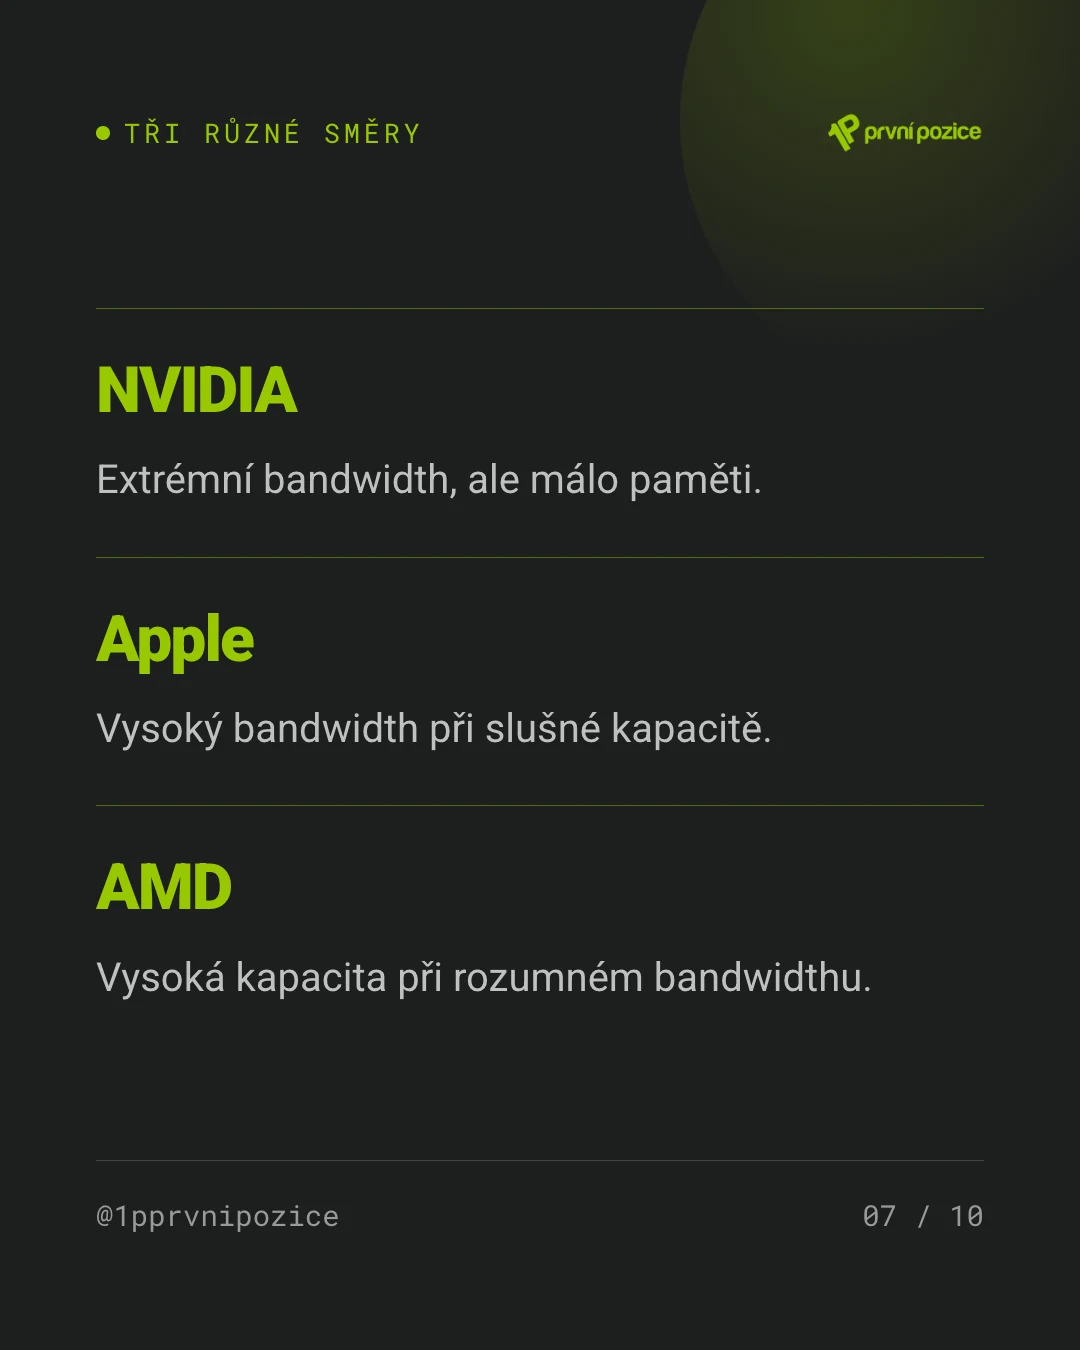
To dobře ukazuje tři různé směry vývoje:
- NVIDIA — extrémní bandwidth, ale málo paměti.
- Apple — vysoký bandwidth při slušné kapacitě.
- AMD — vysoká kapacita při rozumném bandwidthu.
A co obyčejné PC?
Právě tady začíná být situace zajímavější. Pokud nepotřebujeme 30 nebo 50 tokenů za sekundu a spokojíme se například s jednotkami tokenů za sekundu, nemusíme vůbec kupovat speciální AI počítač.
Můžeme vzít:
- běžný Ryzen,
- 64 nebo 128 GB DDR5,
- levnou základní desku,
- NVMe disk,
- a dokonce žádnou dedikovanou grafickou kartu.
Model poběží přímo na CPU.
Na první pohled to zní jako špatný nápad. Jenže u velkého modelu může CPU relativně rychle narazit právě na maximum propustnosti dvou paměťových kanálů. Přidávání dalších jader pak při sekvenčním generování nepřináší zdaleka lineární zrychlení.
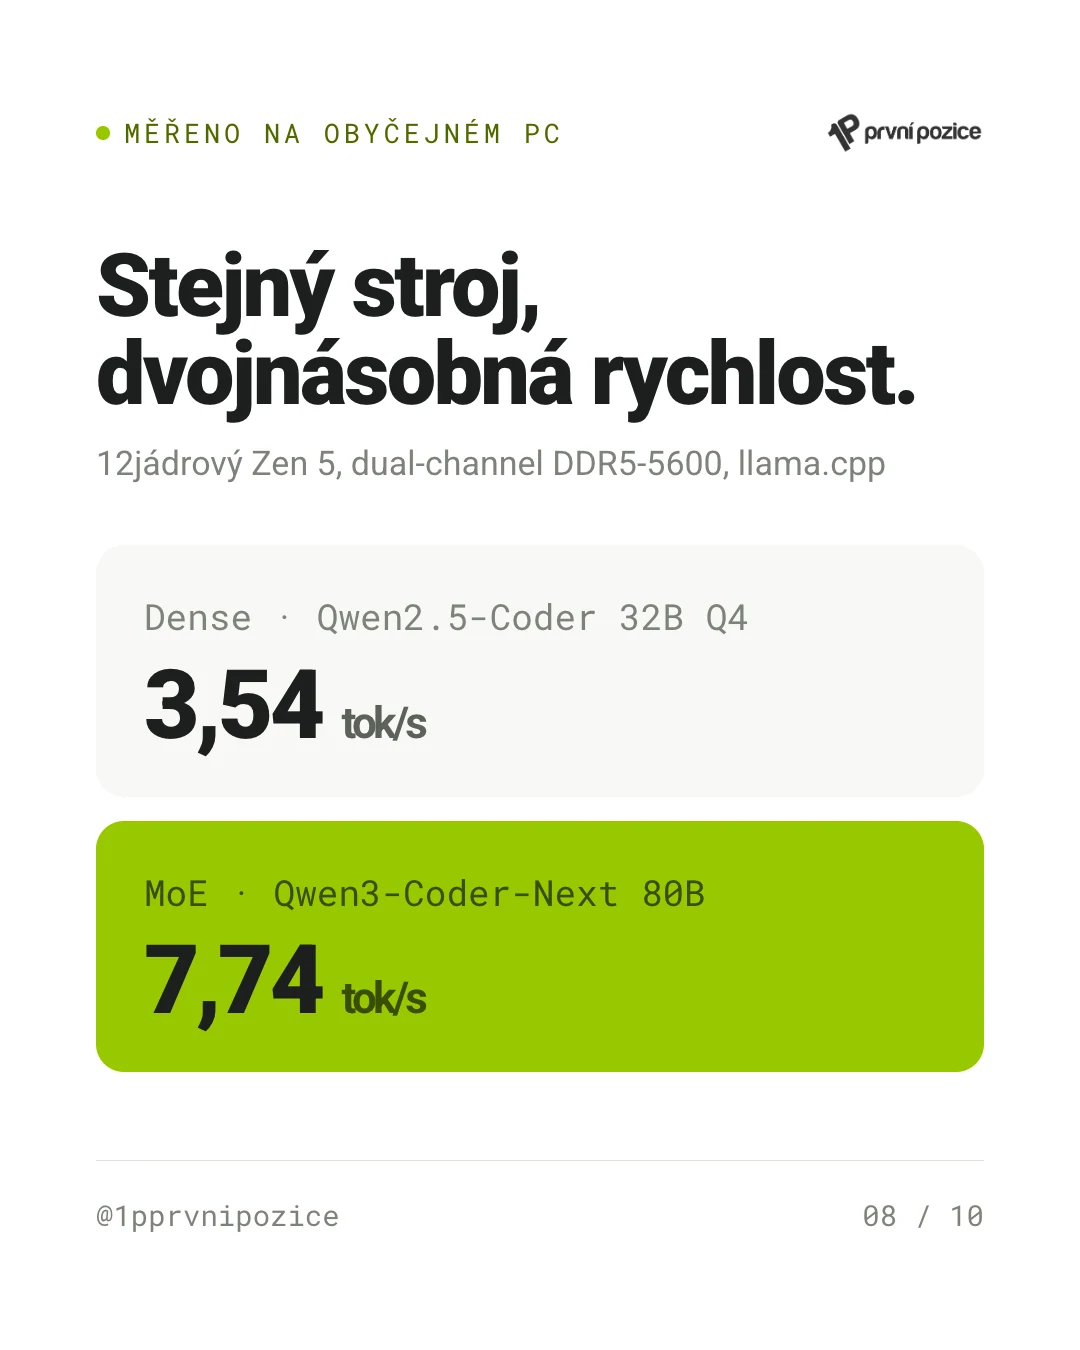
Výborně to ukazuje praktický benchmark llama.cpp/Ollama na 12jádrovém Zen 5 systému s dual-channel DDR5-5600. Dense Qwen2.5-Coder 32B v Q4 zabíral 19 GB a generoval 3,54 tokenu/s. To odpovídalo přibližně 65 GB/s efektivně využité paměťové propustnosti.
Na stejném hardwaru ale 80B MoE model Qwen3-Coder-Next dosáhl 7,74 tokenu/s. A tím se dostáváme k nejzajímavější části celého srovnání.
Dense versus MoE
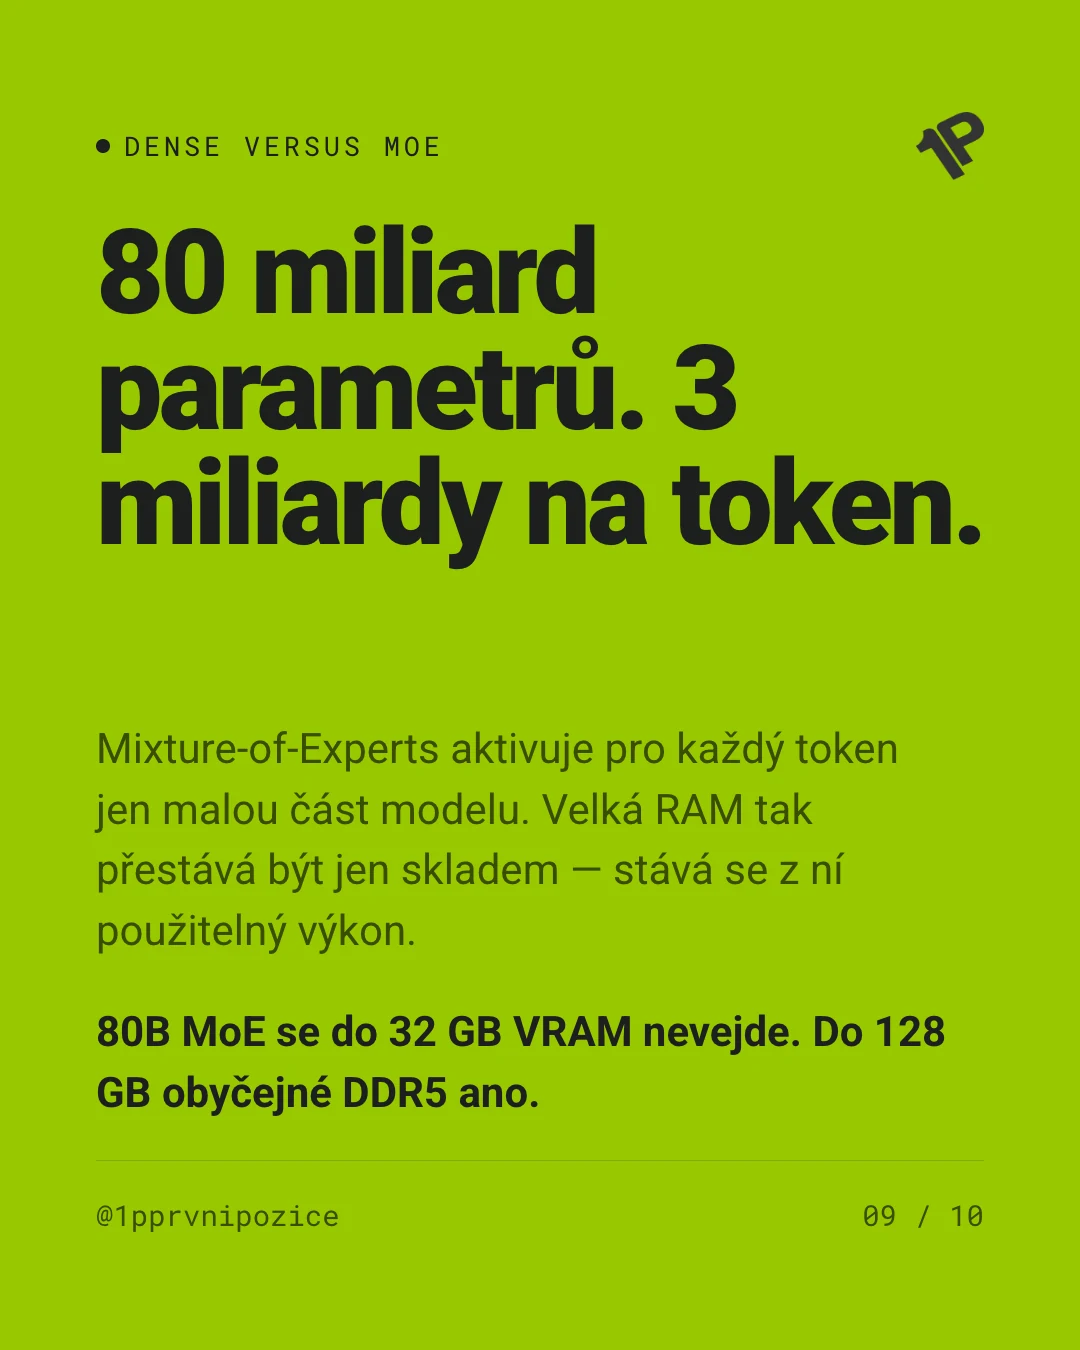
U klasického „dense“ modelu se při každém tokenu používá prakticky celý model. U architektury Mixture-of-Experts může mít model například 80 miliard parametrů, ale pro jeden token aktivovat pouze 3 miliardy.
Qwen3-Next-80B-A3B má právě 80B parametrů celkem a pouze 3B aktivních. Navíc používá hybridní attention architekturu optimalizovanou pro velmi dlouhý kontext. Nativně podporuje 262 144 tokenů.
Najednou tedy začíná dávat smysl počítač, který by u klasického 80B modelu působil téměř absurdně pomalu. Velká RAM už neslouží jen k provozu obrovského dense modelu. Může v ní ležet velký MoE model, ze kterého se pro každý token používá jen malá část.
A tady se vrací ta ostrá hrana u grafické karty. Osmdesátimiliardový MoE model se do 32 GB VRAM nevejde. Do 128 GB běžné DDR5 ano — jen pomaleji.
Proč jsme zatím nic nekoupili
Na papíře nám z tohohle srovnání vyšla jako nejzajímavější poměrně nudná sestava: běžný Ryzen 9 a 128 GB standardní DDR5. Dost paměti na velký MoE model i dlouhý kontext, cena zlomková proti unified memory platformám, plná kontrola nad daty.
A přesto ji zatím nemáme. Ne proto, že bychom si nebyli jistí čísly. Ale proto, že hardware je až druhá otázka. První je, k čemu ho vlastně použít.
Postupujeme proto obráceně, než se obvykle čeká. Nejdřív hledáme konkrétní scénáře, které firmám něco reálně ušetří nebo umožní — analýzu dokumentů, práci nad interní dokumentací, kontrolu smluv, noční dávkové úlohy. Ty pak výpočetně porovnáváme s tím, co jednotlivé sestavy zvládnou: kolik paměti si scénář vyžádá, jak dlouhý kontext potřebuje, jestli mu vadí, že odpověď přijde za dvě minuty.
Teprve až se sejde dost scénářů, které dávají smysl provozně i ekonomicky, dává smysl něco pořizovat. Do té doby nám na testy stačí to, co už provozujeme.
A mezitím se objevila třetí cesta
Během těch testů se navíc ukázalo něco, s čím jsme na začátku série vůbec nepočítali.
Jedna velká evropská serverovna teď experimentálně nabízí provoz velkých jazykových modelů přímo u sebe. Tedy model, který si doma na vlastním železe nerozjedete — ale zároveň běžící na konkrétním hardwaru v konkrétní evropské lokalitě, ne u amerického poskytovatele.
Máme z toho první vlastní naměřená čísla. Zatím to říct nahlas nemůžeme celé, protože měření pořád běží. Ale jedno už je jasné: mění nám to pohled na to, jak se rozhodovat. Volba totiž není binární — vlastní server, nebo cloud. Mezi tím vzniká patro, které se ještě před rokem nedalo koupit.
Nejdřív se ale podíváme na to, co ta obyčejná sestava se 128 GB doopravdy zvládne. Ve třetím dílu si ukážeme, co na takovém stroji skutečně provozovat a jak dlouho může trvat práce se 100tisícovým kontextem.
Celý díl ve zkratce — 41 sekund:
Chcete AI, která nepustí data z firmy?
Otevřené modely na vlastním serveru stavíme klientům nejčastěji tam, kde je citlivé know-how a cloud nepřipadá v úvahu. Jak takové AI aplikace a agenti vypadají v praxi, ukazujeme na samostatné stránce. Ozvěte se nám a projdeme, co by dávalo smysl u vás.
Souvisí: V prvním dílu jsme se dívali na opačný extrém — AI model vypálený přímo do čipu, kde se obětuje univerzálnost výměnou za rychlost.
Držíme vás na první pozici. Teď i s AI. 💚