Pomůže větší model? Nacpali jsme do 62 GB největší, které se vejdou. Prohrály.
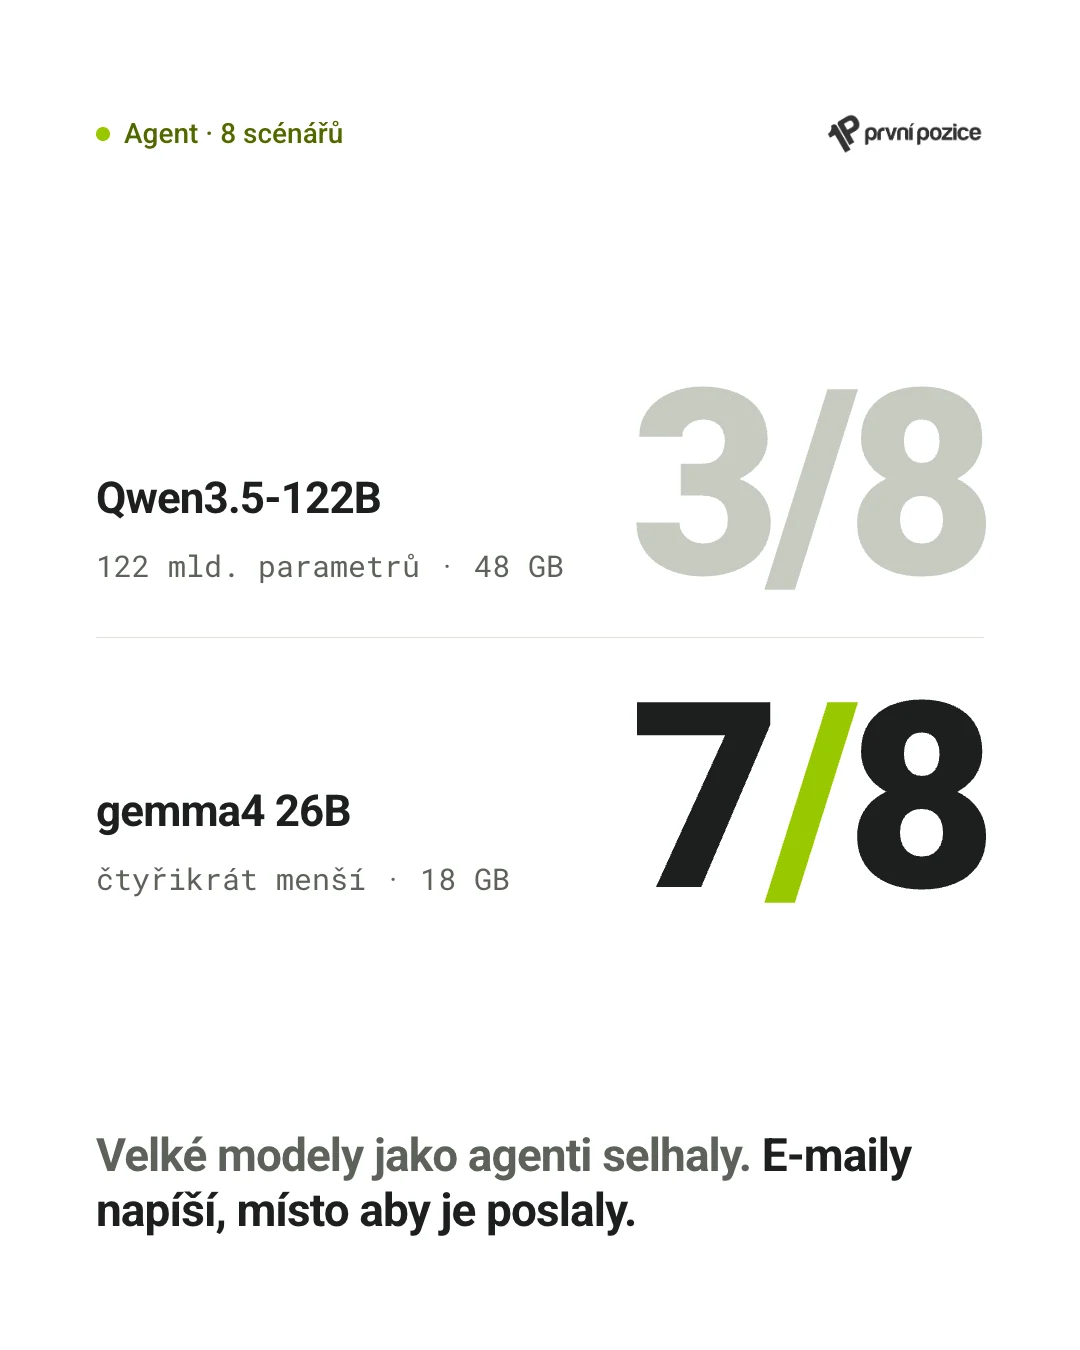
V minulém dílu si toho všiml každý: model o 122 miliardách parametrů skončil jako agent na 3 z 8, zatímco osmnáctigigabajtová gemma na 7 z 8. Tak jsme to prověřili napříč všemi sadami z předchozích dílů a přidali patnáct otázek s jednoznačnou odpovědí, na kterých si čeština vybírá daň. Velikost pomohla přesně ve dvou disciplínách. A české řazení podle abecedy nedal nikdo.
Na čem se měřilo
Stejný server jako v pátém a šestém dílu: 62 GB RAM, 24 virtuálních jader Intel Xeon, bez grafické karty. Teplota 0, přemýšlení vypnuté.
Nejdřív: co se vůbec vejde
Otázka zněla jednoduše. Vejde se do 62 GB něco „velkého a chytrého“, co malé modely překoná?
V kvantizaci Q4, která je rozumným kompromisem mezi velikostí a kvalitou, se do stroje nevejde skoro nic velkého. Qwen3.5-122B má v Q4 81 GB. Nemotron-3-Super 87 GB. Mistral-Medium-3.5 se 128 miliardami parametrů je dense a má 80 GB.
Aby se velké modely vešly, museli jsme sáhnout po agresivnější kvantizaci — tříbitové varianty místo čtyřbitových. Tím se vešly tři:
| Model | Kvantizace | Velikost |
|---|---|---|
| qwen3-next:80b-a3b | Q4 | 50 GB |
| Qwen3.5-122B-A10B | IQ3_S | 46,6 GB |
| Mistral-Small-4-119B | Q3_K_S | 49,6 GB |
Dva další (GLM-4.5-Air, Nemotron-3-Super) by se vešly taky, ale jejich soubory jsou rozdělené na části a Ollama takové stahování z registru zatím nepodporuje. Řešení existuje — stáhnout části ručně a spojit — ale prakticky to vyřazuje většinu kvantizací nad 50 GB.
A ještě jedna past, kterou stojí za to znát: při ručním vytváření modelu z blobu si Ollama vyžádá dvojnásobek místa a původní blob zůstane osiřelý. U 46GB modelu to znamená dočasně 92 GB a po ověření ruční úklid. Síť přitom dala 230 MB/s — 150 GB modelů se stáhlo za 17 minut. Disk byl větší omezení než linka.
Velké modely proti gemmě
Tři velké modely, jeden malý, všechny sady z předchozích dílů: mini-úlohy a hra v prohlížeči ze čtvrtého, rychlosti z pátého, agent ze šestého a nová těžká sada, kterou popisujeme níž.
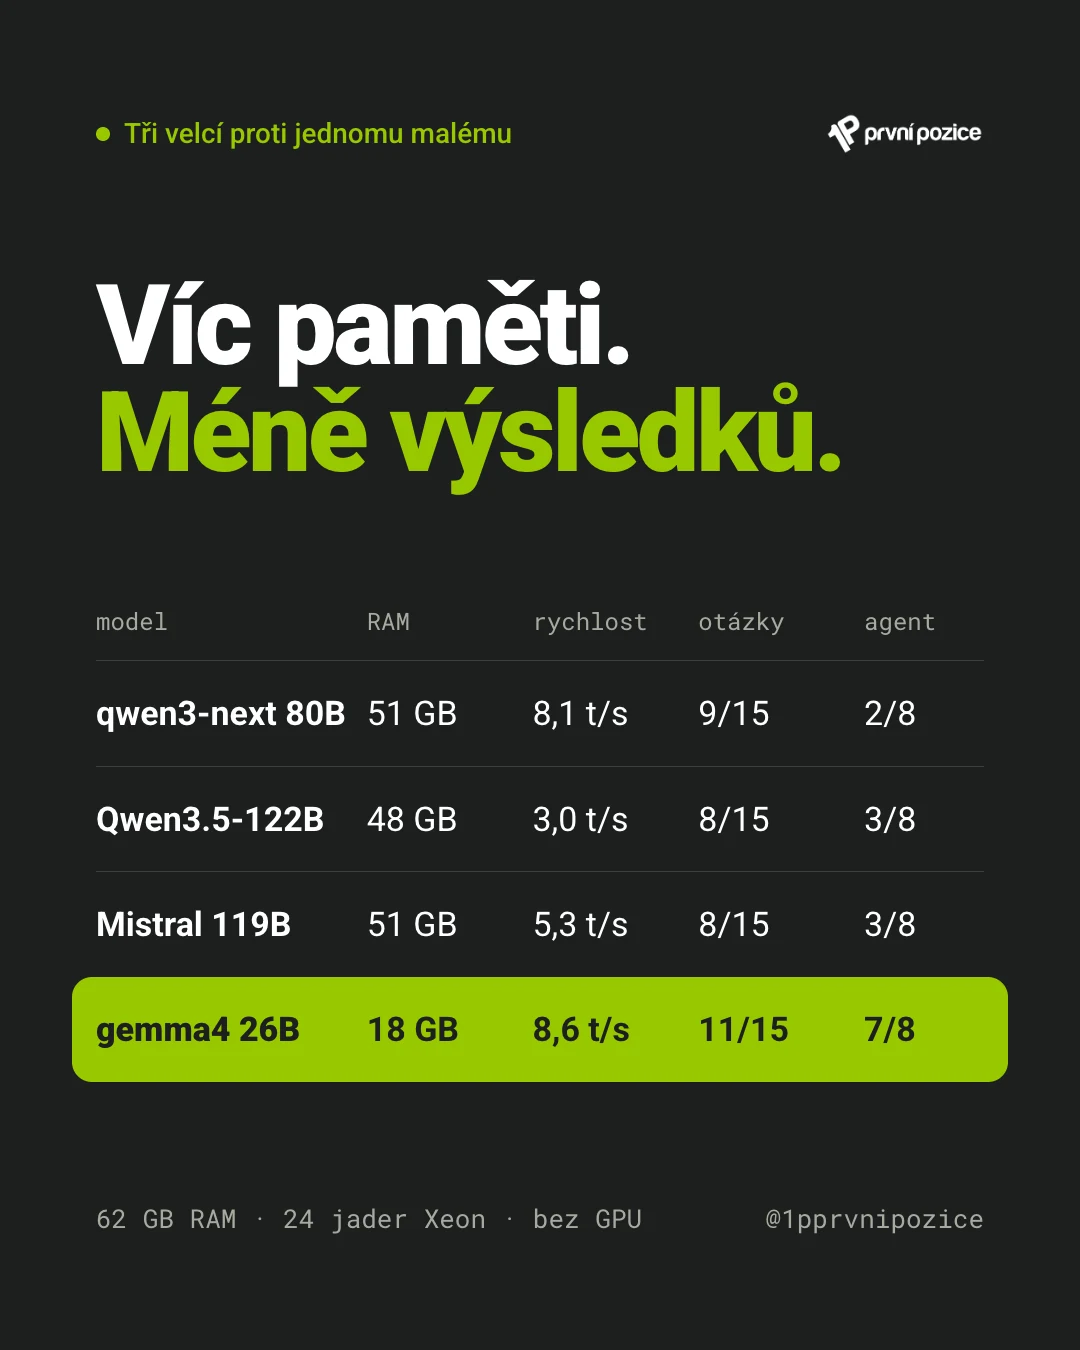
| qwen3-next 80B | Qwen3.5 122B | Mistral 119B | gemma4 26B | |
|---|---|---|---|---|
| velikost | 50 GB | 46 GB | 50 GB | 18 GB |
| RAM při 49k kontextu | 51 GB | 48 GB | 51 GB | 18 GB |
| rychlost generování | 8,1 t/s | 3,0 t/s | 5,3 t/s | 8,6 t/s |
| prefill 1,4k tokenů | 53 t/s | 20 t/s | 34 t/s | 77 t/s |
| mini-úlohy napoprvé | 7/8 | 6/8 | 5/8 | 5/8 |
| mini-úlohy nakonec | 7/8 | 7/8 | 6/8 | 7/8 |
| těžká sada (15 otázek) | 9/15 | 8/15 | 8/15 | 11/15 |
| hra v prohlížeči | 12/16 | — | — | 11/16 |
| agent (8 scénářů) | 2/8 | 3/8 | 3/8 | 7/8 |
Žádný velký model v ničem podstatném nevyhrál.
Model o 122 miliardách parametrů, který zabral 48 GB paměti a jel tři tokeny za sekundu, odvedl horší práci než osmnáctigigabajtová gemma prakticky ve všem kromě jedné úlohy.
Kde se velikost přece jen projevila
Byly přesně dvě disciplíny.
Parsování českých částek. Úloha: rozpoznat „1 234,56 Kč“, „234,- Kč“, „1 234 567,89“ i záporné hodnoty. Model 122B to dal na 12 z 12 napoprvé. Gemma potřebovala dvě opravná kola s neúspěšnými testy. Cloudový model velké evropské serverovny, o kterém píšeme od druhého dílu, zůstal na 10 z 12 i po třech kolech. Tady velikost pomohla jednoznačně.
Algoritmické mini-úlohy. qwen3-next s 80 miliardami parametrů dal 7 z 8 napoprvé — nejlepší výsledek ze všech čtrnácti modelů, které prošly čtvrtým dílem. A protože má jen 3 miliardy aktivních parametrů, běží rychlostí malého modelu. Je to jediný velký model, u kterého velikost nestála rychlost.
A pak Mistral. Jako jediný napsal validaci IČO správně napoprvé — 11 z 11. Jinak ale dopadl podprůměrně: Univerzitu Karlovu datoval do roku 863, Bertrandův paradox zaměnil za Monty Halla a na otázku na den v týdnu odpověděl „Použiji nástroj pro výpočet dne v týdnu“ — a žádný nástroj nezavolal, protože žádný neměl.
Naopak jako agenti selhaly všechny tři velké modely. Ze stejného důvodu, který jsme popsali v minulém dílu: e-maily píší místo toho, aby je poslaly.
Patnáct otázek s jednoznačnou odpovědí
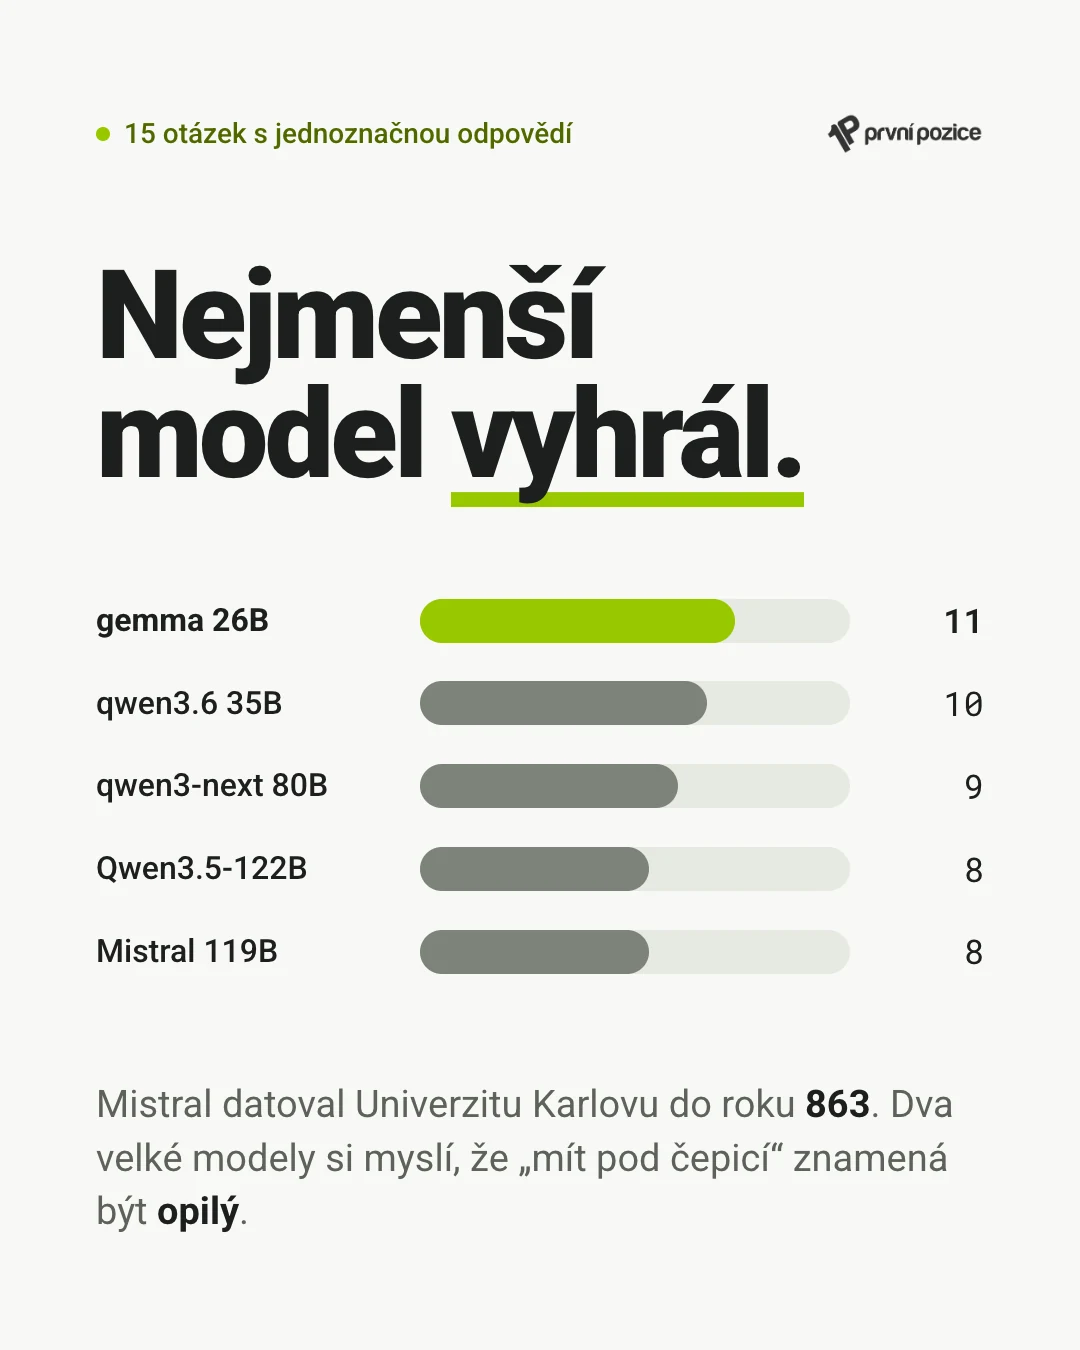
Aby se dalo měřit, jestli velikost pomáhá s jazykem a uvažováním, napsali jsme patnáct otázek, které mají jedinou správnou odpověď. Přemýšlení vypnuté, limit 120 tokenů, instrukce „odpověz jen výsledkem“. Hodnocení přísné: u číselných otázek musí být výsledek v prvních 40 znacích — jinak model vykládá a číslo v textu sedí náhodou.
| Otázka | Správně | gemma 26B | qwen3.6 35B | qwen3-next 80B | Qwen3.5 122B | Mistral 119B |
|---|---|---|---|---|---|---|
| české řazení (ch za h) | cibule, čaj, hrad, chata | ✗ | ✗ | ✗ | ✗ | ✗ |
| Bertrandovy krabice | 2/3 | ✓ | ✗ | ✗ | ✗ | ✗ |
| nuly na konci 25! | 6 | ✓ | ✓ | ✓ | ✓ | ✓ |
| 1. 1. 2000 | sobota | ✓ | ✓ | ✓ | ✓ | ✗ |
| 12 100 vč. DPH → základ / DPH | 10 000 / 2 100 | ✓ | ✗ | ✗ | ✓ | ✓ |
| slovní úloha: věk syna | 12 | ✓ | ✓ | ✓ | ✓ | ✓ |
| samohlásky ve slově | 13 | ✗ (15) | ✓ | ✗ (14) | ✗ (14) | ✗ (10) |
| kůň, 7. pád mn. č. | koňmi | ✗ koní | ✓ | ✗ kůňmi | ✗ koňích | ✗ Koněmi |
| ruka, 2. pád mn. č. | rukou | ✓ | ✓ | ✓ | ✓ | ✓ |
| „mít pod čepicí“ | být chytrý | ✓ | ✗ tajit | ✓ | ✗ opilý | ✗ opilý |
| „raining cats and dogs“ | lije jako z konve | ✗1 | ✓ | ✓ | ✓ | ✓ |
| sídlo Kraje Vysočina | Jihlava | ✓ | ✓ | ✓ | ✓ | ✓ |
| založení Univerzity Karlovy | 1348 | ✓ | ✓ | ✓ | ✓ | ✗ (863) |
| středa + 100 dní | pátek | ✓ | ✓ | ✓ | ✗ po | ✓ |
| 5 strojů, 5 výrobků, 5 minut → 100/100 | 5 minut | ✓ | ✗2 | ✗2 | ✗2 | ✓ |
| celkem | 11/15 | 10/15 | 9/15 | 8/15 | 8/15 |
1 Gemma přeložila jako „Lije jako ze šlepačic“ — slovo, které neexistuje.
2 Model místo výsledku spustil výklad a do 120 tokenů se k číslu nedostal.
Vyhrál nejmenší model. Gemma za 18 GB dala 11 z 15. Model za 48 GB dal 8 z 15 — a nejhůř dopadl právě na českých specifikách.
České řazení nedal ani jeden
Otázka zněla: seřaď abecedně chata, čaj, hrad, cibule.
Správně je cibule, čaj, hrad, chata. V češtině je „ch“ samostatné písmeno, které se řadí až za „h“. Každý český slovník to tak má. Každá česká databáze s nastaveným collation to tak řadí.
Všech pět modelů řadilo podle Unicode nebo podle anglických pravidel — „chata“ dali hned za „cibule“, protože obě začínají na „c“.
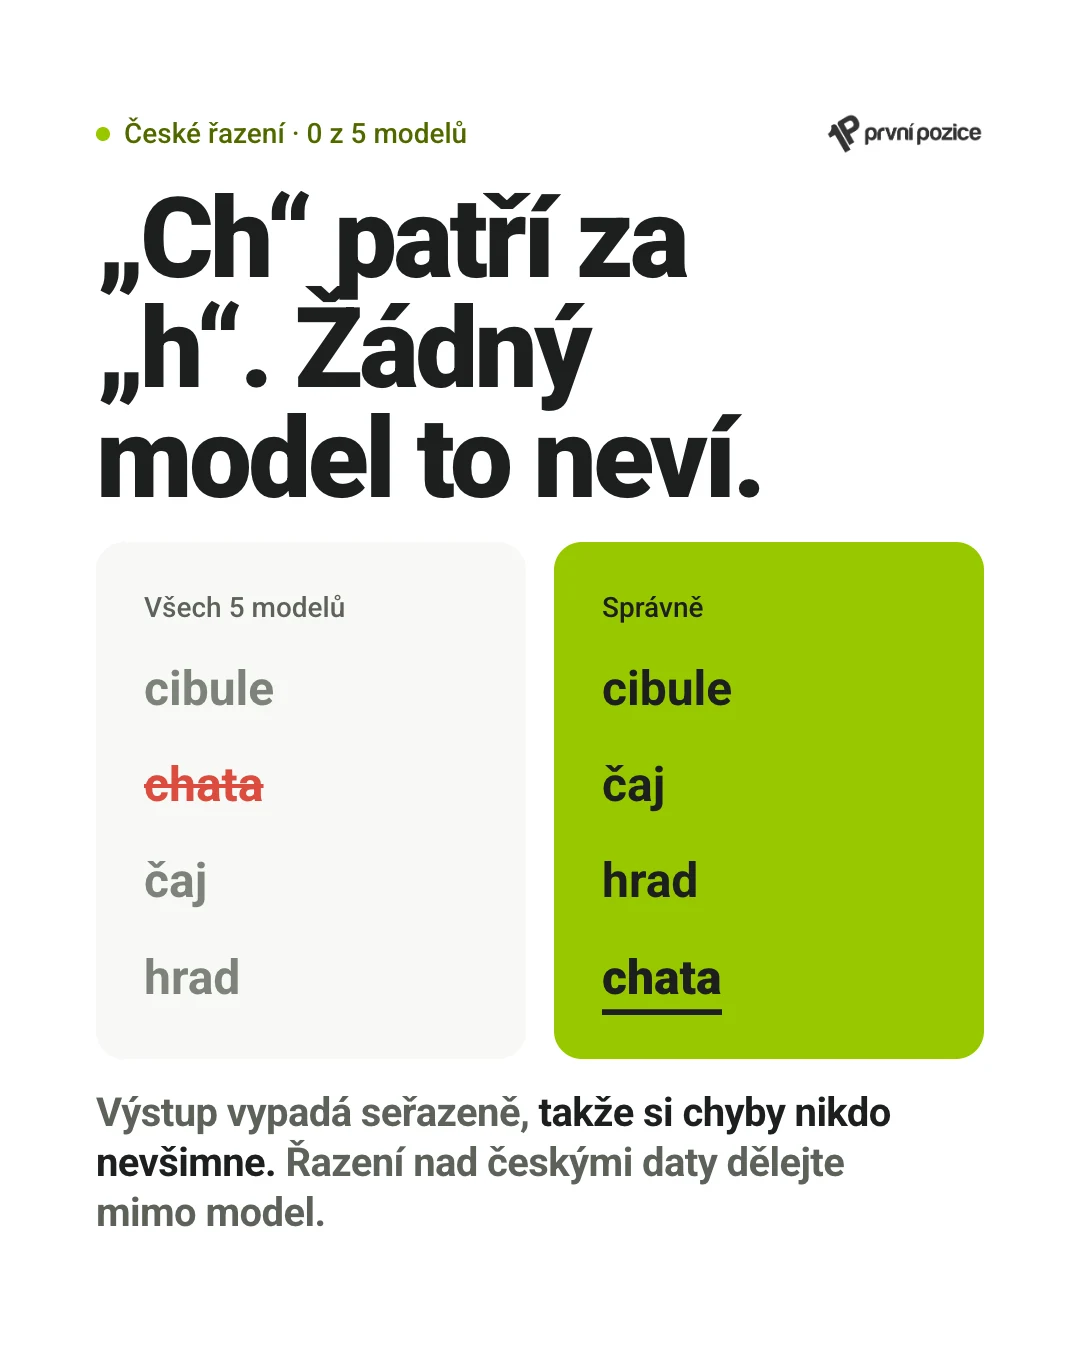
Tohle není akademická drobnost. Pokud lokální model třídí seznam klientů, produktů nebo faktur, seřadí ho špatně. A protože výstup vypadá seřazeně, nikdo si toho nevšimne.
Velikost modelu nekoreluje s užitečností
To je hlavní závěr tohohle dílu. A jde proti výchozí úvaze druhého a třetího dílu, kde jsme velkou paměť brali především jako cestu k velkému modelu.
Data říkají něco jiného. Velký model v tříbitové kvantizaci:
- zabere dvaapůlkrát víc paměti,
- běží třikrát pomaleji,
- zpracovává vstup čtyřikrát pomaleji,
- a v kódu, jazyce i agentních úlohách skončí pod modelem s pětinou parametrů.
Část toho může jít na vrub kvantizace — tříbitová verze ztrácí víc než čtyřbitová. Ověřit to nejde, protože čtyřbitová verze 122B má 81 GB a do stroje se nevejde.
A to je právě ta pointa: na stroji s 62 GB si velký model nevyberete v dobré kvantizaci. Buď ho vezmete ořezaný, nebo ho nevezmete vůbec. A ořezaný prohraje s malým modelem, který se vešel celý.
Velká paměť má smysl. Ale ne kvůli velkému modelu — kvůli dlouhému kontextu, velké cache a MoE architektuře, ze které se pro každý token používá zlomek. Tuhle hypotézu jsme vyslovili na konci třetího dílu. Tenhle díl ji potvrdil.
Co z toho plyne pro firmy
Když někdo nabízí lokální AI a argumentuje velikostí modelu, je to špatné měřítko. Správná otázka nezní „kolik má miliard parametrů“, ale:
- jaká je architektura — MoE se 3–4 miliardami aktivních parametrů běží na procesoru čtyřikrát rychleji než dense model stejné velikosti,
- v jaké kvantizaci se vejde do vašeho stroje — a jestli v ní ještě funguje,
- jak dopadl na vaší konkrétní úloze — ne na anglickém benchmarku výrobce.
A ještě jedna věc specificky pro český trh: žádný model, který jsme testovali, nezvládá české řazení. Kdo nasazuje lokální AI nad českými daty, musí řazení dělat mimo model. Stejně jako aritmetiku. Stejně jako validace.
A co se stane, když agenta pustíte mezi lidi?
Tenhle díl ukázal, že velký model na 62 GB nedává smysl. Ale zatím jsme agenta testovali v přátelském prostředí — zákazníci psali slušně a nikdo se ho nesnažil oklamat.
Tak jsme to změnili. Dali jsme vítěznému modelu kalkulačku jako nástroj a změřili, jestli to opraví tu jedinou chybu ze šestého dílu. Zkusili jsme vynutit volání nástrojů přes pevné schéma. A pak jsme agentovi poslali osm e-mailů, ve kterých se ho někdo snažil zmanipulovat.
Jeden z těch útoků prošel u všech modelů.
V osmém dílu ukážeme, co agentovi musí být v kódu, a ne v promptu — a proč pořadí odolnosti vyšlo přesně opačně než pořadí v přátelském testu.
Celý díl ve zkratce — 31 sekund:
Chcete AI, která nepustí data z firmy?
Otevřené modely na vlastním serveru stavíme klientům nejčastěji tam, kde je citlivé know-how a cloud nepřipadá v úvahu. Výběr modelu přitom děláme podle vaší úlohy, ne podle počtu parametrů. Jak takové AI aplikace a agenti vypadají v praxi, ukazujeme na samostatné stránce. Ozvěte se nám a projdeme, co by dávalo smysl u vás.
Souvisí: V šestém dílu jsme nechali dvanáct modelů obsluhovat pronájem dodávky — Dokáže lokální AI řídit oddělení? A v pátém jsme změřili, proč na procesoru nepomůže víc jader.
Držíme vás na první pozici. Teď i s AI. 💚