Jsme první, kdo testuje weby na AI personách? Prošli jsme ČR, Evropu i svět
Testujeme weby na panelu AI person dřív, než klientovi doporučíme změnu. Chtěli jsme vědět, jestli to takhle dělá ještě někdo. Prošli jsme Česko, Evropu i světový trh — a odpověď je nepříjemnější a zároveň zajímavější, než jsme čekali: dělá. Ale pokaždé na velkých projektech.
Krátká odpověď: první nejsme
Nejsme první na světě, kdo používá syntetické persony k rychlému testování webů a produktových nápadů. Nejsme první ani v Česku. Kdo tvrdí opak, buď průzkum neudělal, nebo doufá, že ho neuděláte vy.
Zajímavější je ale druhá otázka: na jak velkých zakázkách to kdo dělá. A tam se obrázek mění. Všechno, co jsme našli, běží na velkých projektech — celých redesignech, produktových launchích, kampaních za statisíce. Na jednotlivé úpravy existujícího webu kontrolovaný test nikdo nepouštěl. Ne proto, že by na to nikdo nepřišel, ale protože se to nevyplatilo.
Co jsme ale k 21. srpnu 2026 nenašli: českou webovou agenturu, která by celý kontrolovaný experiment používala jako standard běžné klientské práce — pevný malý panel rozhodovacích person, oddělená ramena, kontrolní současný stav, placebo změnu, hypotézy a prahy stanovené před testem a strojovou kontrolu, že závěr vychází jen z toho, co na testované stránce opravdu bylo.
Jednotlivé díly toho řetězce v Česku existují. Celý řetězec jako rutinní součást malé webové zakázky jsme veřejně popsaný nenašli.
Česko: syntetické panely tu už fungují
Nejdůležitější nález je brněnský Lakmoos AI. Není to zahraniční teorie, ale česká firma, která staví syntetické respondenty pro okamžitý market research včetně úzkých cílovek a B2B nákupčích. Uvádí validace proti lidským benchmarkům, přes tisíc provedených syntetických průzkumů a reference jako Škoda X, Volkswagen Group, Raiffeisenbank nebo Mattoni — všechny veřejně doložené případovkami.
Pro nás je nejzajímavější jejich nabídka pro agentury. Lakmoos výslovně popisuje situaci, kdy agentura dostane uprostřed projektu otázku „funguje tenhle headline na skeptiky?“ a místo svolávání kvalitativního výzkumu ji otestuje skoro okamžitě. Myšlenka „klient něco chce → nejdřív se zeptáme syntetického trhu → přineseme čísla“ tedy v Česku existuje minimálně jako technologická nabídka. Jako platforma, kterou si agentura pořídí a provozuje nad velkými zadáními — ne jako položka, která se sama od sebe přidá k opravě jedné podstránky.
Co u nich veřejně popsané není: kombinace kontrolního stavu, placebo ramene, replikace předchozí studie, předem uzamčených prahů a kontroly, že persona cituje jen skutečně existující prvky stránky. Jejich těžiště je jinde — v kvalitě a kalibraci samotného panelu.
Druhý český precedent přinesli v červnu 2026 Webotvůrci s praktickým testem e-shopu. Čtyři AI persony tam paralelně procházejí web v samostatných prohlížečích a výsledkem je společná syntéza a prioritizovaný seznam problémů. Webová agentura používající AI persony jako součást UX práce tedy v Česku existuje. Jde ale o audit celého e-shopu, ne o experimentální ramena a porovnání jedné změny proti kontrole.
Vedle toho běží tradiční český B2B výzkum na skutečných lidech. Ipsos Business Connect má přes 5 000 ověřených B2B profesionálů a rozhodovatelů, B-inside nabízí pre-testy a post-testy reklamních konceptů. Tady jsou respondenti opravdoví — a to je jejich zásadní výhoda i jejich zásadní limit.
Evropa je dál, než by člověk čekal
Uxia z Barcelony nabízí AI testery pro prototypy i živé weby bez náboru respondentů a sama doporučuje rychlé opakované testování v agilních sprintech a porovnávání designových variant. Syntetické testování staví jako první rychlou validační vrstvu, lidský výzkum doporučuje tam, kde je potřeba hlubší kontext. Adresátem je ale produktový tým s vlastním výzkumným rozpočtem, který si nástroj zavede a používá průběžně — ne klient, který si objednal opravu kontaktní stránky.
Making Science už v březnu 2025 popisovala vlastní model syntetických uživatelů pro UX a UI, obohatitelný o firemní a zákaznická data, použitelný na koncepty, wireframy i jednotlivé funkce před implementací.
Synthetic Users umožňují přesně definovat profesní publikum, vyhodnocovat několik variant sdělení paralelně a generují shrnutí pro stakeholdery. Službu sami popisují jako průběžný zdroj insightů mezi velkými výzkumy — přesně tam, kde je klasický research moc pomalý nebo moc drahý.
Takže ani v Evropě by nešlo tvrdit, že syntetické uživatele na UX nikdo před námi nepoužil. Používá — a dělá to dobře. Všechny tři případy mají ale společné to, že se prodávají jako nástroj nebo jako výzkumná zakázka. Obojí předpokládá projekt, který takovou položku unese.
Nejblíž je nám americký Subconscious
Největší konkurent našemu principu není Synthetic Users ani Uxia. Je jím Subconscious.ai.
Ten už otevřeně říká, že správná otázka nezní „co si AI persona myslí“, ale jestli byla alternativa randomizovaná proti kontrole a jestli zůstaly ostatní podmínky konstantní. Provozuje kontrolované randomizované experimenty na simulované populaci.
Metodicky je nám ze všech nalezených firem nejblíž. Uvádí 93% přesnost replikace proti skutečným lidským výsledkům na korpusu více než 350 publikovaných studií ve dvaceti oborech a stejný experimentální design pak ověřuje i na skutečných respondentech.
Tedy prakticky stejná logika, k jaké jsme došli my — a je fér to říct nahlas. Rozdíl je v tom, kdo je zákazník. Subconscious prodává platformu produktovým a výzkumným týmům, které si ji zavedou a obsluhují samy. My stejnou logiku aplikujeme na zakázky malých a středních firem, kde žádný výzkumný tým není a kde by se samostatně objednaný test nikdy nezaplatil. Nezávislé prvenství si tím nenárokujeme.
V čem tedy rozdíl vidíme
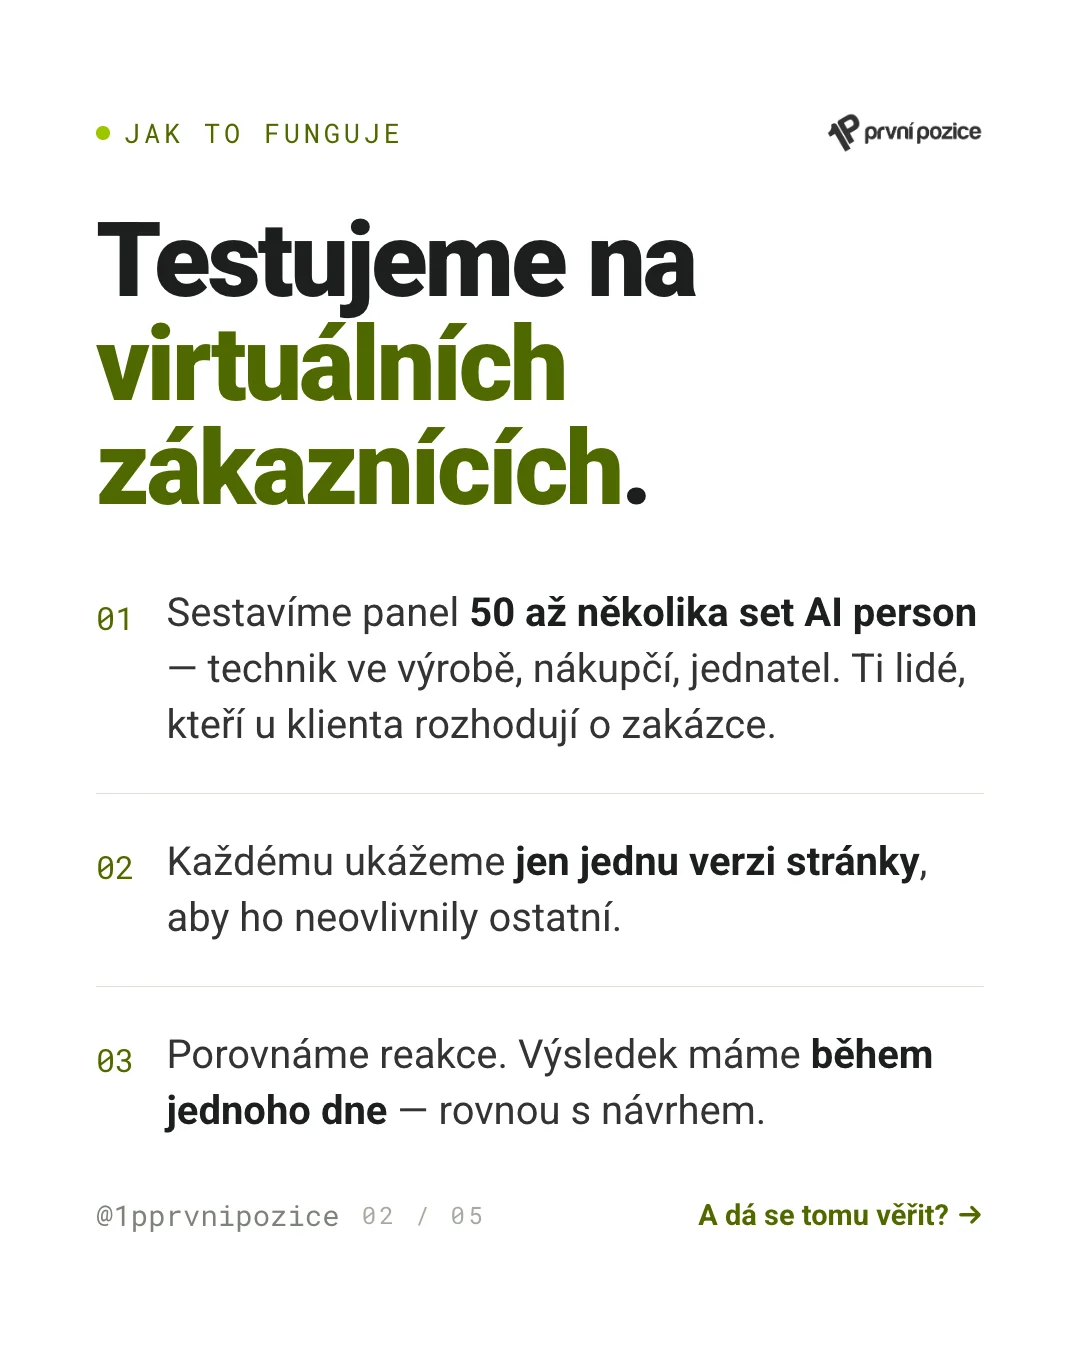
Když si jednotlivé prvky rozebereme zvlášť, skoro každý už někde existuje. Syntetické persony, úzké B2B role, testování webu, více variant, oddělená ramena, malý panel, krátký report pro management — to všechno trh zná.
Neobvyklý je až obal kolem toho. Veřejný komerční ekvivalent jsme nenašli u těchhle čtyř věcí:
- Placebo rameno — jedné skupině ukážeme prakticky nezměněnou stránku a tvrdíme, že je nová. Když ji začne chválit, panel odměňuje slovo „nové“ a testu se nedá věřit.
- Replikace předchozí studie jako interní kalibrace, tedy kontrola, jestli stejný panel dá při opakování stejný výsledek.
- Predikce a rozhodovací prahy uzamčené před spuštěním, aby se výsledek nedal zpětně vysvětlit tak, jak se zrovna hodí.
- Strojová kontrola důkazů — když persona zdůvodní názor prvkem, který na testované stránce vůbec nebyl, výsledek automaticky vyřadíme.
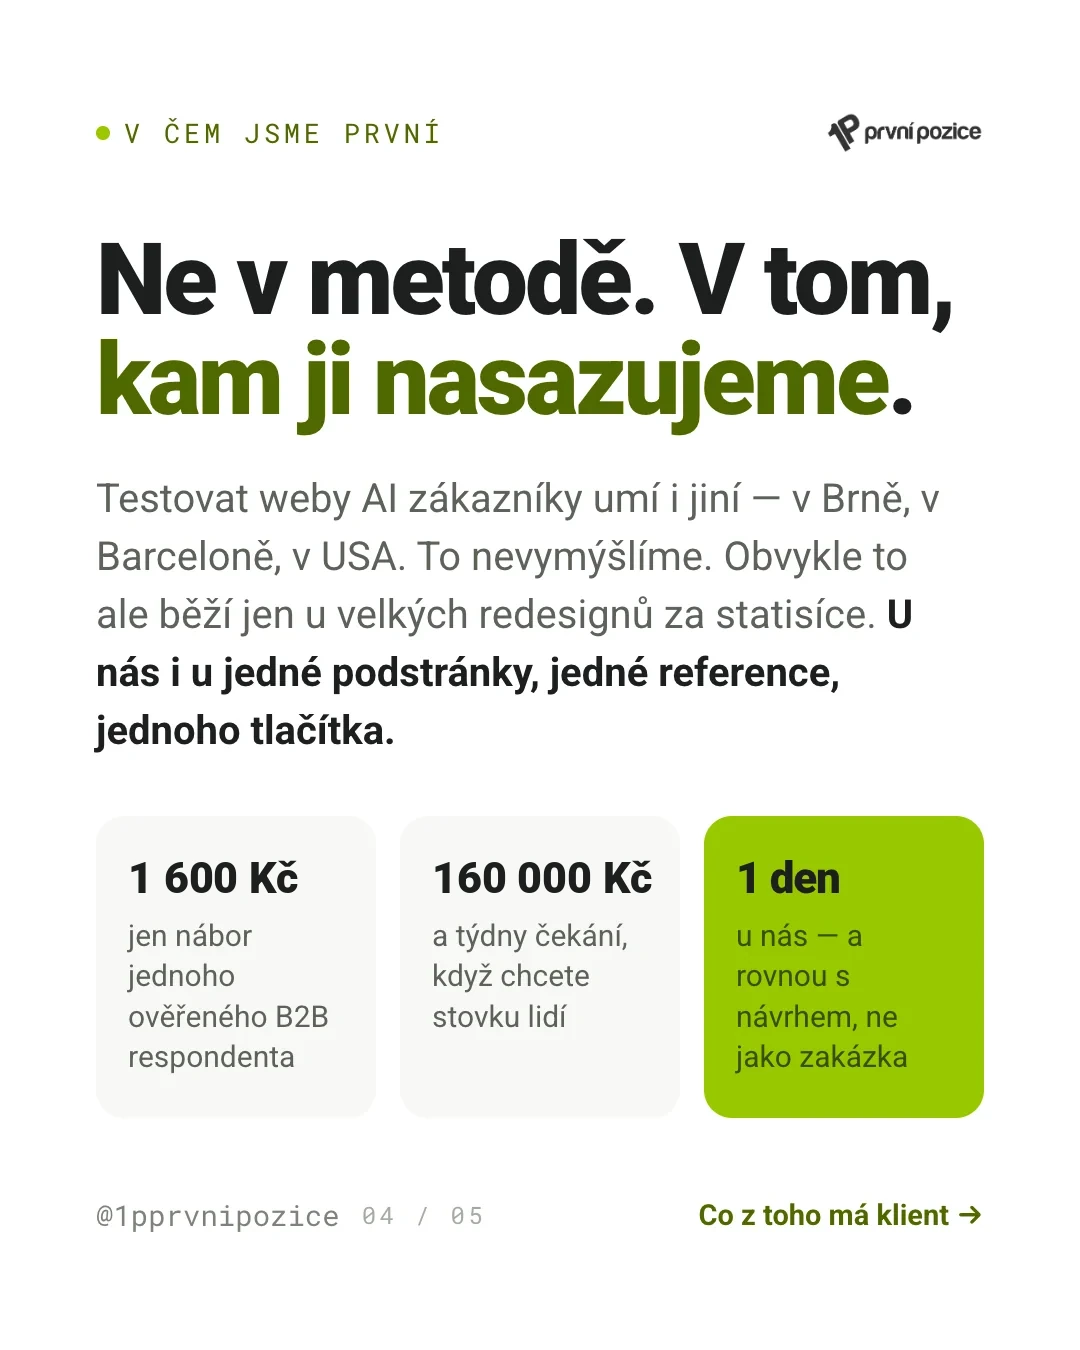
A pak je tu pátá věc, která je vlastně nejdůležitější: kde se to používá. Kontrolované testování obvykle běží jen u velkých redesignů za statisíce, protože se nikde jinde nevyplatilo. U nás i u jedné podstránky, jedné reference, jednoho tlačítka.
Proč to na skutečných lidech u každé malé změny nejde
Není pravda, že lidský výzkum je vždycky pomalý. Moderní panely umí být rychlé — Respondent uvádí přes 4,3 milionu ověřených účastníků a u některých typů výzkumu reakce ve stejný den.
Problém není proveditelnost. Problém je ekonomika opakování.
Náš typický test má 24 person ve 4 oddělených ramenech, tedy 96 odehrání. Kdybychom chtěli čistý lidský ekvivalent, ve kterém respondent nevidí ostatní verze, potřebovali bychom 96 nezávislých B2B sessions.
Veřejná pay-as-you-go sazba náboru, srpen 2026. Přepočteno kurzem 20 Kč za dolar. Jen nábor — bez odměny respondentům, návrhu studie, moderace, analýzy a reportu.
K tomu ještě jedna věc, kterou ceníky neukazují: naše cílovka jsou technici a nákupčí ve výrobních firmách určité velikosti a oboru. Právě takové profily se shánějí nejhůř. User Interviews ve zprávě State of User Research 2024 uvádí 62 % výzkumníků s problémem najít dost správných lidí a 61 % s problémem, jak dlouho nábor trvá.
Klasický B2B výzkum tedy dává smysl u rozhodnutí za statisíce. Nedává smysl objednávat sto respondentských sessions pokaždé, když klient řeší headline, jednu referenci nebo jedno tlačítko.
A právě v té nerovnováze je celé jádro věci. V naší případovce z výrobní firmy vyšel balíček úprav, který zvedl důvěru nejvíc, na 20 000 Kč. Lidský ekvivalent testu, který to ověřil, by stál 153 600 Kč — skoro osminásobek samotné opravy. Tady je odpověď na to, proč kontrolovaný test u malých úprav nikdo nedělal. Nedával ekonomicky smysl.
Naše teze proto nezní „AI je levnější než focus group“. Zní takhle: lidský výzkum nechceme nahradit. Chceme výzkum dostat i k těm tisícům rozhodnutí, na která si ho dnes nikdo neobjedná.
Co klientům zásadně neposíláme
Tady jsme na sebe přísní. Nikdy nenapíšeme „29 % cílové skupiny by poslalo poptávku“.
Píšeme: „V našem syntetickém panelu deklarovalo poptávku 29 % proti 8 % u současné varianty. Výsledek je vhodný pro porovnání variant, ne jako předpověď skutečné konverze.“
Důvod je metodologický, ne opatrnický. Nielsen Norman Group doporučuje syntetické uživatele jako doplněk skutečného výzkumu, ne jako jeho náhradu — výstupy se podle ní mají brát jako hypotézy k ověření. Studie z února 2026 nad americkými daty World Values Survey, postavená na více než 70 000 dvojicích respondent–otázka, navíc zjistila, že přidávání podrobných atributů persony spolehlivost nutně nezvyšuje a u hůř zastoupených skupin ji zhoršuje. Jiný benchmark napříč několika modely našel systematické přeceňování rozdílů mezi demografickými segmenty: rozdíl mezi skupinami vyšel zhruba dvakrát až čtyřikrát větší, než jaký je mezi skutečnými lidmi, a přeháněl ho každý testovaný model. Jinými slovy, model dokáže vyrobit rozdíl, který u skutečných lidí není. (Práce je zatím preprint v recenzním řízení.)
Totéž platí pro statistiku. Když všech 24 person zvedne hodnocení nové verze proti kontrole a znaménkový test vrátí p = 6 × 10⁻⁸, je to velmi silný důkaz vnitřní konzistence panelu. Není to důkaz, že stejné p platí vůči populaci skutečných českých techniků a nákupčích. Náš panel není náhodný vzorek populace, ale pevná sada simulovaných rozhodovacích modelů. Proto to číslo nenazýváme p-hodnotou trhu, ale párovou konzistencí panelu.
Paradoxně to důvěryhodnost zvyšuje. Klient vidí, že mu neprodáváme AI čísla převlečená za reprezentativní průzkum.
Jak to tedy říkáme veřejně
Tohle si troufneme napsat a obhájit:
„Výzkum u nás není samostatná drahá fáze projektu. Syntetický pre-test používáme průběžně i u malých změn webu. Každou významnější variantu porovnáváme se současným stavem na pevném panelu cílových person a klient dostává výsledek společně s doporučením.“
A tohle taky:
„Na českém webovém trhu jsme nenašli jinou agenturu, která by veřejně popisovala stejný standard: kontrolované syntetické pre-testy i u běžných klientských úprav, s pevnými personami, kontrolními rameny a auditovatelným vyhodnocením.“
Nenapíšeme „jsme první v Evropě“ ani „jsme první na světě“. Kvůli Lakmoos, Uxia, Synthetic Users a hlavně Subconscious by to někdo vyvrátil během odpoledne — a právem.
Kde je skutečná výhoda: v datech, ne v prvenství
Syntetické persony budou do roka běžná funkce v desítkách nástrojů. Prodávat je jako novinku nemá smysl. Co se kopíruje mnohem hůř, je proces rozhodování a data, která se v něm nasbírají.
U každé změny, kterou takhle otestujeme a pak nasadíme, měříme po nasazení skutečné poptávky a prokliky. Za rok z toho vznikne databáze stovek záznamů ve tvaru syntetický odhad → doporučení → nasazená změna → skutečný výsledek.
Teprve pak půjde říct věci jako: „když panel ukáže posun deklarované poptávky o 10 procentních bodů, v reálných datech historicky vidíme medián +X %“ nebo „posun míry důvěry pod +3 % nepředpovídá měřitelnou změnu“. V ten okamžik už nevlastníme AI persony. Vlastníme kalibrovaný rozhodovací systém pro webové změny.
A to je podstatně cennější než nálepka „první v ČR“.
Co si z toho odnést
Kategorie syntetického mikrovýzkumu právě vzniká a staví ji několik velmi dobrých firem. Absolutní prvenství si nepřipisujeme. Konkrétní kombinaci kontrol, opakovaného pevného B2B panelu a mikroexperimentu zabudovaného do běžné klientské práce jsme ale na českém trhu veřejně doloženou nenašli. A hlavně jsme nenašli nikoho, kdo by ji pouštěl na zakázky téhle velikosti — na jednotlivé úpravy webů malých a středních firem.
Jak to vypadá v praxi, ukazuje případovka, kde test čtyř verzí webu odhalil, že samotný redesign by klientovi nepřinesl nic. Co panelové průzkumy umí a kdy dávají smysl, popisujeme na samostatné stránce.
Ozvěte se nám a projdeme, co by šlo proměřit u vás dřív, než do toho dáte peníze.
Držíme vás na první pozici. Teď i s AI. 💚